技术面试问题回顾与总结
- 掌握计科五大件:
编译原理、计网、计组、操作系统、数据结构和算法,常见面试题. - 具有一定的代码框架设计能力,熟悉常用
设计模式, 有面向对象开发经验。 - 熟练掌握
网络编程、熟悉TCP/UDP、HTTP协议及Socket,以及其他以太网通信协议。 - 熟练掌握
C++11之后的语言特性,保证代码的可维护性和可扩展性。 - 掌握
系统构建、调试、异常分析和性能优化的基本方法。 - 掌握
多线程、异步编程等并发编程开发必要方法、框架和组件,掌握性能优化方法。 - 理解并能够应用各种数据
序列化和反序列化技术,如JSON, XML, Protocol Buffers等。 - 具备较强的逻辑思维和代码阅读能力;能持续学习,钻研问题,不断提升质量和效率。
编译原理
从源码到可执行文件的过程
点击展开
一个C++程序从源码到执行文件,有四个过程,预处理、编译、汇编、链接。
预处理(Preprocessing)
g++ -E hellp.cpp > hello.i[.cpp → .i]
- 清理代码,过滤所有的注释、多行语句合成一个逻辑行,添加行号和文件名标识。
- 处理各项预处理指令
| 预处理指令 | 描述 |
|---|---|
#include |
将指定头文件的内容插入到当前位置。 |
#define |
定义宏,宏可以是简单的文本替换,也可以是带参数的宏。 |
#undef |
取消之前的宏定义。 |
#ifdef、#if、#else、#elif、#endif |
根据条件编译指令决定是否编译某段代码。 |
#pragma once 或 #ifndef/#define/#endif |
防止头文件被重复包含。 |
#error |
编译时产生错误信息。 |
#line |
修改行号。 |
#pragma |
向编译器发出特定的指令。 |
编译(Compilation)
g++ -S hello.i[.i → .s]
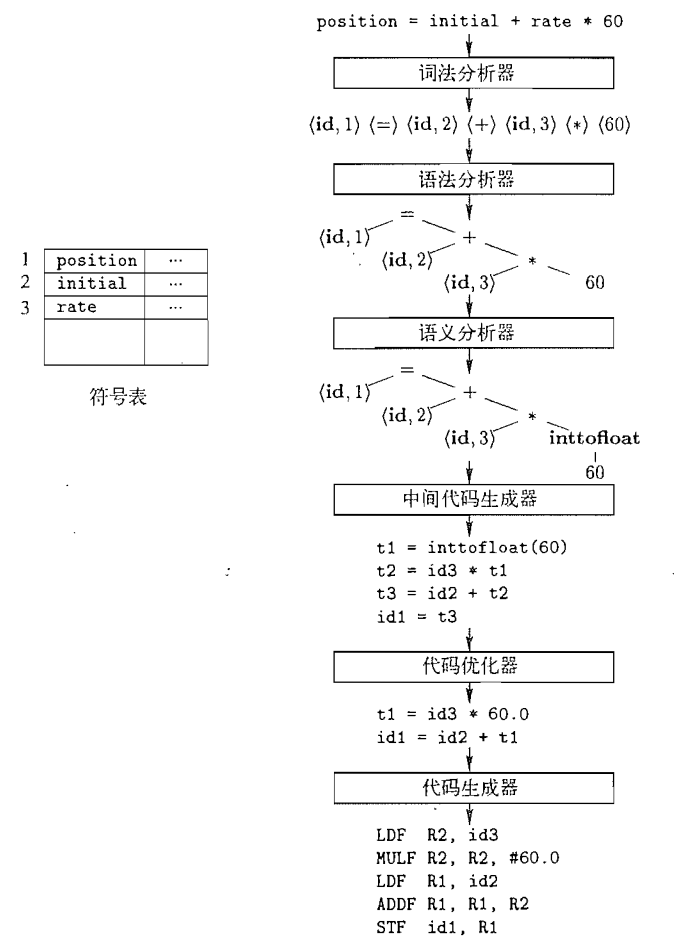
编译器将预处理后的代码转换为汇编语言,包含以下几个步骤:
- 词法分析(lexical analysis):将源代码的字符流分割成一系列的符号流。
- 语法分析(syntax analysis):对符号进行语法分析,产生语法树。
- 语义分析(semantic analysis):检查符号表和语法树的语义,判断表达式是否有意义。
- 中间代码生成(intermediate code generation):通常是低级的或类似汇编语言的中间代码。
- 代码优化(code optimization):对中间代码进行优化,提高代码执行效率。
- 目标代码生成(target code generation):将优化后的中间代码转换为目标机器的汇编代码。
汇编(Assembly)
g++ -c hello.s[.s → .o]
- 这个过程主要是将汇编代码转变成机器可以执行的指令。
- 每个源文件对应一个目标文件_.o_,目标文件是二进制文件,包含机器指令、数据和符号表等信息。
链接(Linking)
g++ hello.o -o hello[.o → bin]
将不同的源文件产生的目标文件和库文件链接形成一个可以执行程序,链接过程主要包括以下几个步骤:
- 地址和空间分配:链接器会根据目标文件的大小和布局,确定每个模块在最终可执行文件中的位置。
- 符号决议:链接器会解析每个目标文件中的符号引用,找到符号的定义,并将引用替换为实际地址。
- 重定位:调整代码和数据中的地址引用,反映它们在最终可执行文件中的实际位置,以便在可执行文件中正确地定位符号。
链接分为静态链接和动态链接。
静态链接:
- 在链接时将所有需要的库函数和过程嵌入到最终的可执行文件中。
- 生成的静态链接库在 Windows 下以
.lib为后缀,在 Linux 下以.a为后缀。 - 静态链接的可执行文件在运行时不依赖外部库,即使删除静态库也不会影响程序的执行。
动态链接:
- 在链接时只将库函数和过程的引用嵌入到可执行文件中,而不是将整个库函数和过程。
- 生成的动态链接库在 Windows 下以
.dll为后缀,在 Linux 下以.so为后缀。 - 动态链接的可执行文件在运行时依赖外部库,需要在运行时加载动态链接库。
拓展阅读:
交叉编译与本地编译
点击展开
交叉编译是在一个架构(Host,如 x86)上生成另一种架构(Target,如 ARM)可执行文件的过程。
为什么需要交叉编译?
- 资源限制:目标平台的 CPU 性能低、内存和存储容量小,无法承载庞大的编译器及其依赖库。
- 构建效率:PC/服务器性能强劲,利用 PC 进行交叉编译能大幅缩短大型项目的构建时间。
- 环境初始化:目标板卡在刚出厂或系统尚未跑起来时,板载无操作系统或编译工具链,必须依靠 PC 端编译好固件/镜像烧录进去。
C++语言特性
多态
点击展开
-
简述多态实现的原理
多态可以分为静态多态(编译时多态)和动态多态(运行时多态),可以理解为
函数重载 & 模板和函数重写。静态多态- 实现方式:
函数重载,由编译器确定的 - 具体实现:
- 允许在同一个作用域中声明多个功能类似的同名函数
- 这些函数的参数列表、参数个数、参数类型、参数顺序不一样
- 注意不能通过返回值来区别重载
- 实现原理:
- 函数名修饰
- 编译过程
- 预编译:把头文件中的函数声明拷贝到源文件,避免编译过程中语法分析找不到函数定义
- 编译:语法分析,同时进行符号汇总(函数名)
- 汇编:生成函数名和函数地址的映射,方便之后通过函数名找到函数定义的位置,从而执行函数
- 链接:将多个文件中的符号表汇总合并
- 通过objdump -t *.o : _ZN+类长度+类名+函数名长度+函数名+E+类型首字母
- 实现方式:
动态多态- 实现方式:
虚函数重写,由运行时确定的 - 具体实现:
- 在基类的函数名前加上virtual关键字,在派生类中重写该函数
- 运行时将会根据对象的类型来调用相应的函数
- 如果对象的类型是基类,则调用基类的函数
- 如果对象的类型是派生类,这调用派生类的函数
- 实现原理:
- 早绑定:编译器编译时已经确定对象调用的函数的地址
- 晚绑定:若类使用了virtual函数,则编译器会为类生成虚函数表,他是一个一维数组,存放虚函数的地址。
- virtual关键字用于声明一个函数为虚函数。虚函数主要用于实现多态,即允许在派生类中重写(override)基类中的函数。虚函数表指针在构造函数中初始化。
- 实现方式:
-
虚函数表和虚函数表指针
- 虚函数表
- what:
虚函数表是一个存储类的虚函数地址的数组,每个包含虚函数的类或者从这样的类派生的类都有一个虚函数表。 - how:虚函数表的内容在编译器编译的时候已经生成,当一个类的对象被创建时一个虚函数表也会被创建并与该对象关联。
- why:虚函数表用于实现动态多态性。动态多态性允许我们通过基类指针调用派生类的函数。
- where:虚函数表存放在全局数据区中的只读数据段中,每个对象的内存布局中都有一个指向虚函数表的指针。
- when:有一个基类指针,并且想调用派生类的函数时,需要使用虚函数表。
- what:
- 虚函数表指针:
- what:
虚函数表指针是一个指向虚函数表(vtable)的指针,每个包含虚函数的类或者从这样的类派生的类的对象都有一个虚函数表指针。 - when:对象构造的时候,在构造函数,将虚函数表的地址赋值给对象vptr。
- how:继承下虚函数表指针赋值过程:
- 如果类没有构造函数,则编译器为类生成默认构造函数,从而为类对象初始化vptr。
- 接着调用子类构造函数的时候,又将子类的虚函数表地址赋值给vptr。
- what:
- 虚函数表
-
为什么不能有“纯虚构造函数”?
在C++中,构造函数不能声明为虚函数,即不能写
virtual Base::Base() = 0;。- 虚函数表指针未初始化:虚函数的调用需要通过对象的虚函数表(vtable)来实现,而虚函数表指针是在构造函数体代码执行前的初始化列表中才被初始化的,在对象构造期前,vtable尚未建立,vptr不存在,因此无法通过虚函数表来调用构造函数。
- 语义矛盾:构造函数的主要作用是创建一个当前类的具体对象,而纯虚函数的目的是通过基类指针/引用调用派生类的重写版本实现多态。如果允许纯虚构造函数,那么在基类中就无法创建对象实例,这与构造函数的语义相矛盾。
-
为什么可以有“纯虚析构函数”,说明作用和底层逻辑?
在 C++ 中,析构函数可以声明为纯虚函数,即可以写
virtual Base::~Base() = 0;。- 确保多态安全:通过将基类的析构函数声明为虚函数,可以实现在基类指针指向派生类对象,并通过基类指针调用delete操作时,会先调用派生类的析构函数,然后再调用基类的析构函数,从而确保派生类对象的资源能够正确释放。
- 允许抽象类:纯虚析构函数可以使基类成为抽象类,不能直接实例化,从而强制派生类实现自己的析构函数,确保资源的正确释放。如果想让一个类成为抽象类,通常会将析构函数声明为纯虚函数。
-
重写和重载的区别?
重载(Overload):指在同一个作用域内,函数名相同但参数列表不同的函数,可以通过参数的个数、类型、顺序来区分。重载是一种静态多态,由编译器在编译时根据函数的参数列表来确定调用哪个函数。重写(Override):指在派生类中重新定义基类中的虚函数,实现多态性。重写是一种动态多态,由运行时根据对象的类型来调用相应的函数。
-
构造函数、析构函数的执行顺序?
因为子类在构造函数和析构函数中可以访问父类,所以执行顺序遵守“基类->成员类->派生类,先构造者后析构”的原则。
-
构造函数的执行顺序:
- 基类的构造函数先于派生类的构造函数执行。
- 如果有多个基类,按照继承顺序从左到右依次调用基类的构造函数。
- 派生类的成员变量按照声明顺序初始化调用自身构造函数。
- 最后执行派生类的构造函数体。
-
析构函数的执行顺序:
- 派生类的析构函数先于基类的析构函数执行。
- 如果有多个基类,按照继承顺序从右到左依次调用基类的析构函数。
- 派生类的成员变量按照声明顺序的反向顺序调用自身析构函数。
- 最后执行基类的析构函数体。
-
指针和引用
点击展开
指针和引用的区别
相同点:引用和指针都可以作为参数传递给函数,用于更改函数作用域外的变量;也可以作为函数的参数,在传递大对象时避免复制,提升效率。
| 特性 | 指针(*) | 引用(&) |
|---|---|---|
| 定义 | 指针是一个变量,存储一个地址,指向内存的一个存储单元 | 引用是原变量的一个别名,与对象绑定后,就不可改变 |
| 空值 | 可以为空,可以声明为void | 不能为空,不能声明为void |
| 初始化 | 可以在定义后再赋值 | 定义的时候必须初始化 |
| 大小 | sizeof 是指针大小 |
sizeof 是所引用的对象大小 |
| 嵌套 | 可以有多级指针,指向指针的指针,指向指针的指针的指针…… | 引用不能有引用,引用本身就是一个别名,不能再有别名了,只能有一级引用 |
参考链接:
堆空间和栈空间
点击展开
栈:存放自动变量以及每次函数调用时所需保存的信息。每次调用函数时,其返回地址以及调用者的环境信息(如寄存器的值)都存放在栈中。然后,最近被调用的函数在其栈帧上为其自动和临时变量分配存储空间。
1 |
|
堆:通常用于动态存储空间的分配,内存由程序员管理,必须手动申请和释放。堆的大小主要受限于系统中有效的虚拟内存(超出会抛出std::bad_alloc异常)。堆的分配使用较为复杂的算法,效率比栈要低,且容易产生内存碎片。
1 |
|
左值右值及引用
点击展开
在C++中,左值引用(lvalue reference)和右值引用(rvalue reference)是与变量或表达式的生命周期和使用方式相关联的两种引用类型。
- 左值引用(lvalue reference): 左值引用绑定到具有名称的对象(即左值),并且可以延长其生命周期。左值引用通常用于传递可修改的对象,也可以用于函数重载和模板推断等场景。
1 | int x = 5; // x 是左值 |
- 右值引用(rvalue reference): 右值引用绑定到临时对象或表达式(即右值),并且可以延长其生命周期。右值引用通常用于移动语义、完美转发和实现移动构造函数和移动赋值运算符等场景。
1 |
|
在这个示例中,createObject() 函数返回一个临时对象,因此返回值是一个右值。在 main()
函数中,我们使用右值引用 MyClass&& rref
来绑定这个临时对象,延长了它的生命周期,从而使得对象在 main() 函数作用域内仍然有效。
右值引用的绑定延长了对象的生命周期,可以用于实现移动语义,避免了临时对象的不必要拷贝。
右值引用的标志是&&,右值引用专门为右值而生,可以指向右值,不能指向左值:
1 | int &&ref_a_right = 5; // ok |
如何区分左值引用和右值引用?
左值引用和右值引用在语义上有很大的差异,左值引用通常用于可修改的对象,右值引用则通常用于临时对象或表达式,并且可以延长其生命周期以实现移动语义。区分左值引用和右值引用的关键在于理解它们绑定到的对象的生命周期和可修改性。
- 左值引用(lvalue reference)绑定到具有名称的对象(即左值),例如变量或对象的名称。
- 右值引用(rvalue reference)绑定到临时对象或表达式(即右值),例如临时对象、函数返回值、字面量等。
1 | int x = 5; // x 是左值 |
简而言之,可以从下面的角度判断:左值可以取地址、位于等号左边;而右值没法取地址,位于等号右边。
左值引用和右值引用的使用场景:
移动语义:右值引用常用于实现移动构造函数和移动赋值运算符,从而避免了不必要的深拷贝,提高效率。完美转发:即将参数以原样传递给其他函数,无需进行多余的拷贝或移动操作。临时对象的延长生命周期:通过右值引用可以延长临时对象的生命周期,使其在函数调用结束后仍然有效。
下面是一些右值引用的更多使用场景和示例:
1 |
|
拓展阅读:
仿函数
点击展开
在C++中,仿函数(Functor)是一个行为类似函数的对象。它是一个类,该类重载了operator()运算符。因此,我们可以像调用函数一样调用这个类的对象。这就是为什么它被称为仿函数。仿函数可以扩展函数的功能,并且可以保存状态信息,具有很高的灵活性和可复用性。
仿函数在C++中有许多应用场景,以下是一些常见的应用场景:
-
作为STL算法的参数:STL算法,如sort,transform等,通常接受一个函数或者仿函数作为参数。使用仿函数可以使得代码更加灵活和可重用。
点击展开
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
class MyComparator {
public:
bool operator()(int a, int b) const {
return a > b; // 降序排序
}
};
class Add {
int value; // 保存要加的值
public:
Add(int val) : value(val) {} // 构造函数,初始化要加的值
int operator()(int x) const { // 重载函数调用运算符
return x + value; // 返回加法操作的结果
}
};
int main() {
std::vector<int> nums = {3, 1, 4, 1, 5, 9, 2, 6};
std::sort(nums.begin(), nums.end(), MyComparator());
for (int num : nums) {
std::cout << num << " ";
}
std::cout << std::endl; // 输出:9 6 5 4 3 2 1 1
std::vector<int> vec = {1, 2, 3, 4, 5};
std::transform(vec.begin(), vec.end(), vec.begin(), Add(5));
std::cout << "vec: ";
for (int num : vec) {
std::cout << num << " ";
}
std::cout << std::endl; // 输出:vec: 6 7 8 9 10
return 0;
} -
作为比较函数:在STL的数据结构,如set,map,priority_queue等,可以接受一个比较函数或者仿函数来自定义元素的排序方式。
点击展开
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
struct Compare : public std::binary_function<int, int, bool> {
bool operator()(const int& a, const int& b) const {
return a > b;
}
};
int main() {
std::priority_queue<int, std::vector<int>, Compare> pq;
pq.push(3);
pq.push(1);
pq.push(4);
pq.push(1);
pq.push(5);
std::cout << "Priority Queue: ";
while (!pq.empty()) {
std::cout << pq.top() << " ";
pq.pop();
}
std::cout << std::endl; // 输出:Priority Queue: 5 4 3 1 1
return 0;
} -
在回调函数中:仿函数是类对象,可以包含成员变量,因此可以保存状态信息。这使得仿函数在执行函数调用时可以考虑到之前的状态,实现更复杂的功能。
点击展开
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
// 定义一个仿函数 AddWithState
class AddWithState {
private:
int state; // 保存状态信息
public:
// 构造函数,初始化状态信息
AddWithState(int initialState) : state(initialState) {}
// 重载函数调用运算符,将输入值与状态信息相加并返回
int operator()(int x) {
int result = x + state;
state = result; // 更新状态信息
return result;
}
};
int main() {
std::vector<int> vec = {1, 2, 3, 4, 5};
int initialState = 0; // 初始状态信息为 0
// 创建 AddWithState 对象,将初始状态信息传入构造函数
AddWithState adder(initialState);
// 使用仿函数进行加法操作,并将结果保存到 vec 中
std::transform(vec.begin(), vec.end(), vec.begin(), adder);
// 输出每次加法操作的结果
std::cout << "Resulting vector: ";
for (int num : vec) {
std::cout << num << " ";
}
std::cout << std::endl;
return 0;
} -
作为函数对象适配器的参数: 仿函数可以与函数对象适配器一起使用,实现更复杂的功能。例如,std::bind、std::function等可以与仿函数一起使用,实现函数的组合、筛选等操作。
点击展开
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class MyPredicate {
public:
bool operator()(int x) const {
return x % 2 == 0; // 判断是否为偶数
}
};
int main() {
MyPredicate predicate;
std::function<bool(int)> isEven = std::bind(predicate, std::placeholders::_1);
std::cout << isEven(3) << std::endl; // 输出 0
std::cout << isEven(4) << std::endl; // 输出 1
return 0;
}
匿名函数
点击展开
Lambda表达式是 C++11 引入的一个新特性,它允许定义一个匿名函数并立即使用。以下是一些常见的应用场景:
-
排序:可以使用lambda表达式定义自定义的排序规则。例如,可以使用lambda表达式对一个vector的元素进行降序排序:
1
2
3
4std::vector<int> nums = {1, 2, 3, 4, 5};
std::sort(nums.begin(), nums.end(), [](int a, int b) {
return a > b;
}); -
算法:许多C++的STL算法,如std::for_each,std::transform等,都可以接受lambda表达式作为参数。例如,可以使用lambda表达式将一个vector的所有元素都增加1:
1
2
3
4std::vector<int> nums = {1, 2, 3, 4, 5};
std::for_each(nums.begin(), nums.end(), [](int& n) {
n++;
}); -
线程:可以使用lambda表达式创建新的线程。例如,使用lambda表达式在一个新的线程中打印一条消息:
1
2
3
4std::thread t([]() {
std::cout << "Hello from a new thread!" << std::endl;
});
t.join(); -
函数对象:可以使用lambda表达式创建函数对象,这对于需要回调函数的场景非常有用。例如,可以使用lambda表达式定义一个函数,该函数接受一个函数对象作为参数,并在函数内部调用这个函数对象:
1
2
3
4auto print = [](const std::string& message) {
std::cout << message << std::endl;
};
print("Hello, world!");
使用 lambda 表达式有那些优点?
由于匿名函数没有名字,可以直接在代码中定义和使用,因此可以更加灵活地组织代码结构、使代码更加简洁清晰、实现更加精细的控制流程。具体来说使用 lambda 表达式有几个主要的优点:
-
简洁性:lambda 表达式通常比完整的函数定义更简洁,尤其是在函数体很小的情况下。这可以使代码更易于阅读和理解。
-
局部性:lambda 表达式定义在使用它的地方,这可以增强代码的局部性,使得读者不需要在文件中跳来跳去来查找函数的定义。
-
闭包:lambda 表达式可以捕获其外部作用域中的变量,这使得它们可以访问和操作这些变量,即使在 lambda 表达式的定义之外。这是普通函数无法做到的。
-
匿名性:lambda 表达式是匿名的,这意味着你不需要为它们想一个名字。这在你只需要在一个地方使用函数的情况下非常有用。
-
兼容STL:许多标准模板库(STL)的算法,如 std::sort,std::for_each 等,都接受函数对象作为参数。使用 lambda 表达式可以方便地创建这样的函数对象。
这并不意味着在工作中总是使用 lambda 表达式。在某些情况下,使用普通的函数可能更合适,例如当函数体很大,或者需要在多个地方重用同一个函数时。
如何使用 lambda 表达式?
Lambda表达式一般都是以方括号[]开始,然后是圆括号(),接着是花括号{},其基本语法如下:
1 | [] (int a, int b) -> int { return a + b; } |
其中:
[]:捕获列表,用于捕获外部变量。(int a, int b):参数列表。-> int:拖尾返回类型,用于指定lambda表达式的返回类型,也可以省略,让编译器自动推导。{ return a + b; }:函数体。
lambda 表达式的底层实现原理是什么?
Lambda表达式的底层实现通常是一个类,该类重载了函数调用运算符operator(),并且包含了捕获的变量。
在编译时,编译器会将lambda表达式转换为一个匿名类,并生成一个函数调用运算符operator()。在运行时,lambda表达式会创建一个临时对象,然后调用这个临时对象的函数调用运算符operator(),执行lambda表达式的函数体。
例如,以下代码:
1 | int a = 42; |
在编译时会被转换为类似以下的代码:
1 | class __lambda_1 { |
这里__lambda_1是一个自动生成的类,它包含了捕获的变量a,并且重载了函数调用运算符operator(),用于执行lambda表达式的函数体。
实际上,上面提到的编译器生成的类__lambda_1是一个闭包类型(closure type),它包含了捕获的变量和函数调用运算符,用于执行lambda表达式的函数体。闭包的一个强大之处是其可以通过传值或者引用的方式捕捉其封装作用域内的变量,前面的方括号[]就是用来定义捕捉模式以及变量,我们又将其称为 lambda 捕捉块。
常用的几种捕捉方式有:
[]:默认不捕获任何变量;[=]:默认以值捕获所有变量,其中包括this指针。[&]:默认以引用捕获所有变量;[x]:仅以值捕获x,其它变量不捕获;[x, y]:仅以值捕获x和y,其它变量不捕获;[&x]:仅以引用捕获x,其它变量不捕获;[=, &x]:默认以值捕获所有变量,但是x是例外,通过引用捕获;[&, x]:默认以引用捕获所有变量,但是x是例外,通过值捕获;[this]:通过引用捕获当前对象(其实是复制指针);[*this]:通过传值方式捕获当前对象;
拓展阅读:
智能指针
点击展开
概念引入
手动管理内存存在的安全隐患有哪些?
- 内存泄漏:忘记使用 delete 释放已分配的内存,导致内存泄漏。
- 重复释放:多次释放同一块内存,导致程序崩溃。
- 内存越界:访问已释放的内存,导致程序崩溃。
- 野指针:释放了内存但没有将指针置为 nullptr,导致野指针。
智能指针如何解决这些问题?
智能指针在C++中是一种对象,它们可以像原始指针一样指向动态分配的内存,当智能指针离开作用域或被显式删除时,它们会自动删除所指向的内存。
例如,考虑以下代码:
1 | void foo() { |
在这上面个例子中,我们在foo函数中使用new分配了一块内存,但是我们忘记了在函数结束时使用delete释放这块内存,所以发生了内存泄漏。如果如下使用智能指针,这个问题将得到结决:
1 | void foo() { |
当smart_ptr在foo函数结束时离开作用域,它会自动删除所指向的内存,从而防止内存泄漏。
类型区分
C++中有三种类型的智能指针:
std::unique_ptr
这是一种独占所有权的智能指针,同一时间只能有一个 unique_ptr 指向给定的对象。当 unique_ptr 被销毁时,它所指向的对象也会被自动销毁。由于 unique_ptr 某个时刻只能有一个指针指向某个对象,因此它不允许拷贝构造和赋值。
std::shared_ptr
这是一种共享所有权的智能指针,多个 shared_ptr 可以指向同一个对象。该对象只有在最后一个指向它的 shared_ptr 被销毁时才会被自动销毁。每个 shared_ptr 对象在内部维护着两个变量:一个指向所管理对象的原始指针,一个指向引用计数的指针。当一个 shared_ptr 被拷贝或赋值而指向某个动态内存对象时,该对象的引用计数递增。当一个 shared_pt 被赋予一个新值(指向别的对象)或被销毁(释放)时,该对象的引用计数递减。
std::weak_ptr
这是一种不拥有所有权的智能指针。它是为了解决 shared_ptr 可能会引起的循环引用问题而设计的。weak_ptr 可以从一个 shared_ptr 或者另一个 weak_ptr 中构造,但是它不会增加引用计数。
循环引用
循环引用是指两个或更多的对象互相引用,形成一个闭环。在这种情况下,即使没有外部引用,这些对象也无法被垃圾收集器回收,因为它们互相引用,看起来都是“活跃”的。
在C++中,std::shared_ptr可能会导致循环引用。例如,如果你有两个类A和B,它们互相包含对方的 shared_ptr,那么就会形成一个循环引用。即使没有任何其他对象引用这两个对象,它们也不会被销毁,因为它们互相引用。
展开查看代码
1 | class B; |
std::weak_ptr可以帮助解决这个问题。weak_ptr 是一种不控制所指向对象生存期的智能指针,它指向一个由 shared_ptr 管理的对象。将上述代码中的std::shared_ptr 替换为 std::weak_ptr,就可以解决循环引用的问题。
展开查看代码
1 | class B; |
在上面这个例子中,当a和b离开作用域时,它们会被正确地销毁,因为没有std::shared_ptr指向它们。
底层原理
C++智能指针的底层实现通常依赖于原始指针的行为模拟和RAII(资源获取即初始化)机制,通过一个栈上的对象来管理堆内存的生命周期。
- RAII原理:在创建智能指针对象时申请堆内存,当对象离开作用域时,自动调用析构函数释放对应的内容。
- 行为模拟:类的行为模拟原始指针的行为,重载了
*和->运算符,使得对象的行为表现得像原始指针一样。
各种智能指针的底层实现原理如下:
-
std::unique_ptr独占资源所有权,它将拷贝构造函数和赋值运算符删除,禁止复制操作,利用移动语义实现资源的转移。 -
std::shared_ptr底层基于引用计数实现多个 shared_ptr 对象共享同一块堆内存资源。它维护一个引用计数器,当一个 shared_ptr 被创建时,引用计数器加1;当一个 shared_ptr 被销毁时,引用计数器减1;当引用计数器为0时,释放堆内存资源。 -
std::weak_ptr作为std::shared_ptr的辅助工具,它不增加引用计数器的值,不控制对象的生命周期。通过观察 shared_ptr 的控制块,增加弱引用计数,在需要访问时通过 .lock() 提升为 shared_ptr,从而打破 shared_ptr 互相引用导致的循环引用。
使用场景
std::unique_ptr:当你需要确保一个对象在任何时候都只有一个所有者时,或者需要在堆上分配一个对象并确保它在不再需要时被删除时,可以使用unique_ptr。
std::shared_ptr:当你需要在多个所有者之间共享一个对象时,可以使用 shared_ptr。
std::weak_ptr:当你需要一个指向对象的指针,但不需要拥有该对象时,可以使用 weak_ptr。这通常用于解决 shared_ptr 的循环引用问题。
代码示例
展开查看代码
1 |
|
拓展阅读:
并发编程
点击展开
C++ 的并发编程(Concurrency) 是指在程序中同时执行多个任务的编程方式。这些任务可以是同时执行的或交替执行的。并发编程的目标是有效地利用计算资源,提高程序的性能、响应速度以及资源利用率。
可以采用多种方式实现任务的并发执行,包括多线程、异步编程、并行计算等。这些方式可以根据任务的性质、程序的需求以及硬件平台的特性来选择。并发编程通常涉及到原子操作、锁管理、线程间的同步与通信、资源共享与竞态条件等问题,针对这些问题,C++提供了丰富的标准库和工具来支持并发编程。
| 特性 | API |
|---|---|
| thread (线程增强) | std::thread、std::jthread、std::this_thread (sleep_for, yield) |
| future (异步通信) | std::future、std::shared_future、std::promise、std::packaged_task、std::async |
| mutex (互斥锁) | std::mutex、std::recursive_mutex、std::timed_mutex、std::shared_mutex |
| lock RAII (锁管理) | std::lock_guard、std::unique_lock、std::shared_lock、std::scoped_lock |
| condition_variable (条件变量) | std::condition_variable、std::condition_variable_any |
| semaphore (信号量) | std::counting_semaphore、std::binary_semaphore |
| latch & barrier (屏障) | std::latch 、std::barrier |
| atomic (原子操作) | std::atomic、std::atomic_thread_fence、std::atomic_ref |
| interruption (请求中断) | std::stop_token、std::stop_source、std::stop_callback |
| once execution (单次执行) | std::call_once 与 std::once_flag |
线程管理
线程创建
下面的demo演示了如何用std::thread创建四个线程,分别演示了四种不同的创建方式和参数传递方式。
展开查看代码
1 |
|
在线程销毁前要对其调用 join 等待线程退出或 detach 将线程分离,否则 std::thread 的析构函数会调用 std::terminate 终止程序,注意分离线程可能出现空悬引用的隐患。
线程绑定
将线程绑定到一个指定的 CPU core 上运行,避免多核 CPU 上下文切换和 cache miss 的开销。
展开查看代码
1 | static int bind_thread_to_cpu_core(const std::vector<int> &cpu_ids) { |
线程同步
Thread Synchronization 是一种控制多个线程在共享资源上的访问顺序和时机的机制。在多线程环境中,当多个线程同时访问共享资源时,可能会出现竞态条件(Race Condition)和数据不一致等问题,线程同步就是为了解决这些问题而引入的一种手段。
保证线程同步的方法有多种,其中一些常见的方法包括:
互斥锁
Mutex 是一种最常见的线程同步机制,它可以确保在任意时刻只有一个线程能够访问共享资源。线程在访问共享资源之前会先获取互斥锁,访问完成后再释放互斥锁,从而确保了线程的互斥访问。
互斥量的概念可以用一个比喻来理解:假设有一个房间(共享资源),只有拿到房间的钥匙(互斥量的锁)的人才能进入房间(访问共享资源),其他人需要等待拿到钥匙后才能进入。当一个线程拿到了互斥量的锁时,其他线程就无法再拿到该锁,只能等待锁的释放。
C++11 提供了 std::mutex 来创建一个 mutex,可通过 lock 加锁,通过 unlock 解锁,用法示例如下:
展开查看代码
1 |
|
一般不手动使用这两个成员函数,而是使用 std::lock_guard 来自动处理加锁与解锁,它在构造时接受一个 mutex,并会调用 mutex.lock(),析构时会调用 mutex.unlock()。
按照锁的具体类型来分类:
-
互斥锁(Mutex):互斥锁是最基本的锁类型,用于保护共享资源的互斥访问。互斥锁适用于对共享资源的长时间操作,因为它会阻塞其他试图获取锁的线程,直到拥有锁的线程释放锁。std::mutex是C++标准库中提供的互斥锁类。 -
递归锁(Recursive Mutex):递归锁是一种特殊的互斥锁,允许同一个线程多次获得锁。递归锁可以在同一线程内对共享资源进行递归调用,避免死锁的问题。std::recursive_mutex是C++标准库提供的递归锁类。 -
自旋锁(Spinlock):自旋锁是一种特殊类型的互斥锁,当一个线程试图获取一个已经被其他线程持有的自旋锁时,它会在一个循环中不断地尝试获取锁,而不是被阻塞。自旋锁适用于对共享资源的短时间操作,因为它可以避免线程切换的开销。C++标准库中没有提供原生的自旋锁,但可以通过原子操作等机制实现自旋锁的功能。 -
读写锁(Read-Write Lock):读写锁允许多个线程同时读取共享资源,但在任何时候只允许一个线程写入。读写锁可以提高读取操作的并发性能,适用于读取操作频繁、写入操作较少的场景。C++标准库中没有提供原生的读写锁,但可以通过互斥锁和条件变量等组合实现读写锁的功能。
按照对并发控制的思想进行划分:
-
乐观锁(Optimistic Locking):乐观锁是一种并发控制的策略,它假设多个线程在访问共享资源时不会发生冲突,因此在访问资源时不会立即加锁,而是在更新资源时才检查是否有冲突。如果发现冲突,就放弃更新,通常配合重试机制使用。乐观锁适用于冲突少的情况。 -
悲观锁(Pessimistic Locking):悲观锁是一种并发控制的策略,它假设多个线程在访问共享资源时会发生冲突,因此在访问资源时就立即加锁。悲观锁适用于冲突多的情况。
更多关于 C++ 中的锁机制和线程同步的内容,可以参考链接
条件变量
Condition Variable 是一种用于线程间通信和同步的机制,它允许线程在等待某个条件满足时进入阻塞状态,直到其他线程通知条件变量并唤醒它们。条件变量通常与互斥锁一起使用,std::condition_variable用于等待某个条件的发生,而std::mutex用于保护共享资源,确保在访问共享资源时的线程安全性。
最典型的使用场景是生产者和消费者问题:
- 生产者线程负责生成产品,并将产品放入共享队列中。
- 消费者线程负责从共享队列中取出产品,并进行消费。
- 当共享队列为空时,消费者线程需要等待,直到有新的产品放入队列中。
- 当共享队列已满时,生产者线程需要等待,直到有消费者取出产品。
展开查看代码
1 |
|
信号量
Semaphore 是一种计数器,用于控制对共享资源的访问权限。它允许多个线程同时访问共享资源,但可以限制同时访问的线程数量。通过对信号量的增加和减少操作,可以实现对共享资源的访问控制和线程同步。
C++标准库(C++11及更新版本)本身并没有提供信号量的实现,但是在POSIX系统中,可以使用semaphore.h头文件提供的函数来操作信号量。这些函数包括:
| 函数 | 作用 | 声明 |
|---|---|---|
sem_init() |
初始化信号量。 | int sem_init(sem_t *sem, int pshared, unsigned int value); |
sem_destroy() |
销毁信号量。 | int sem_destroy(sem_t *sem); |
sem_wait() |
等待信号量。 | int sem_wait(sem_t *sem); |
sem_trywait() |
尝试等待信号量,如果无法立即获取则立即返回。 | int sem_trywait(sem_t *sem); |
sem_post() |
发送信号量。 | int sem_post(sem_t *sem); |
sem_getvalue() |
获取信号量的当前值。 | int sem_getvalue(sem_t *sem, int *sval); |
以上函数用于创建、销毁、等待和发送信号量,并可以获取当前信号量的值。需要注意的是,这些函数是在POSIX标准中定义的,因此在非POSIX系统上可能不适用,或者需要额外的库支持。
下面是使用信号量解决生产者-消费者问题的例子:
展开查看代码
1 |
|
原子操纵
Atomic 是一种不可分割的操作,它要么完全执行,要么完全不执行,不存在中间状态,可以确保在多线程环境中对共享变量的操作是原子性的,不会被其他线程中断。原子操作通常用于实现对共享变量的安全访问和更新,避免了竞态条件和数据不一致等问题。
std::atomic是C++标准库提供的模板类,用于执行原子操作,支持各种数据类型的原子操作,包括整数、指针、布尔值等,同时支持包括增加、读取、设置、交换等原子操作。
以下是std::atomic模板类的一些常见成员函数:
load():以原子方式读取std::atomic对象的值。store():以原子方式设置std::atomic对象的值。exchange():以原子方式交换std::atomic对象的值,并返回之前的值。compare_exchange_strong()和compare_exchange_weak():以原子方式比较并交换std::atomic对象的值,可以选择强一致性或者弱一致性。
用法示例如下:
展开查看代码
1 |
|
在这个示例中,我们创建了一个std::atomic对象counter,并进行了一系列原子操作,这些操作都是原子性的,不会被其他线程中断,从而确保了对共享资源的操作是安全的。
屏障
Barrier 是一种同步机制,它可以确保所有线程在达到某个指定点之前都必须等待,然后一起继续执行。屏障通常用于多个线程在某个阶段需要等待其他线程都完成某个操作后再继续执行的场景。
C++标准库并没有提供原生的屏障(Barrier)实现。但是可以使用第三方库(如Boost库)提供的屏障来实现线程同步。以下是一个使用Boost库中的屏障的示例:
展开查看代码
1 |
|
在这个示例中,首先创建了一个屏障bar,指定了线程数量为3。然后创建了3个线程,并在每个线程中调用bar.wait()等待所有线程到达屏障。当所有线程都到达屏障后,它们才会继续执行后续的操作。
异步通信
异步(Asynchronous) 允许程序在执行某些耗时操作时不会被阻塞,而是可以继续执行其他任务。
一种常见的实现异步编程的方式是使用C++11引入的std::async和std::future。std::async函数允许我们在一个新的线程或者线程池中执行一个函数,并返回一个std::future对象,用于获取函数的执行结果。通过std::future 对象,我们可以等待异步操作的完成,也可以获取异步操作的结果。
展开查看代码
1 |
|
另一种实现异步编程的方式是使用C++标准库中的std::thread和std::condition_variable等多线程工具,或者使用一些第三方库,比如Boost.Asio等,来处理异步IO操作。
展开查看代码
1 |
|
总的来说,异步编程可以提高程序的性能和响应速度,特别是在需要处理大量IO操作或者并发任务的情况下。
拓展阅读:
关键字
点击展开
static
static 关键字在C++中具有多种用途,用于定义静态变量和静态函数,修改变量的存储区域和生命周期,实现在程序运行期间共享状态信息、提高函数的调用效率等功能。
修饰成员变量:
- 类的 static 变量在所有对象中是共享的,并且在类的所有对象中只有一个副本
- 作用周期是整个程序,而不是对象,在程序开始时分配空间,在程序结束时释放空间
- 不需要生成对象就可以访问该成员,在外部访问时需要加上类名作为限定符,如 Context::static_speed
- 必须在类的外部初始化 static 成员变量
修饰局部变量:
- 函数内部的 static 变量存储在静态区,具有静态存储持续时间,在所用调用中共享一个实例
- 作用周期是整个程序,而不是函数,在第一次调用函数时初始化,之后再调用时保持上次的值
- 作用域仅限于声明它的函数内部,但是当函数返回后,其值不会消失,但是在函数外部不可访问
修饰全局变量:
- 文件作用域内的 static 全局变量只能在定义该变量的文件中使用,不能被其他文件访问
- 作用周期是整个程序,而不是文件,只初始化一次,直到程序结束才销毁
修饰函数:
- 修饰普通函数,表明函数的作用范围,仅在定义该函数的文件内才能使用。在多人开发项目时,为了防止与他人命名空间里的函数重名,可以将函数定位为 static。
- 修饰成员函数,修饰成员函数使得不需要生成对象就可以访问该函数,但是在 static 函数内不能访问非静态成员。
this
this 是一个指向当前对象的指针,它是每个非静态成员函数的隐含参数。它指向调用该成员函数的那个对象。
- 当对一个对象调用成员函数时,编译程序先将对象的地址赋给 this 指针,然后调用成员函数,每次成员函数存取数据成员时,都隐式使用 this 指针。
- 当一个成员函数被调用时,自动向它传递一个隐含的参数,该参数是一个指向这个成员函数所在的对象的指针。
注意:
- this 并不是一个常规变量,它被隐含地声明为
ClassName *const this,而是个右值,所以不能取得 this 的地址(不能 &this),也不能给 this 指针赋值。 - 在以下场景中,经常需要显式引用 this 指针:
- 为实现对象的链式引用
- 为避免对同一对象进行赋值操作
- 在实现一些数据结构时,如 list
volatile
volatile 是一个类型修饰符,用于指示编译器一个变量可能会被程序之外的因素(操作系统、硬件、其它线程等)更改。它是来解决变量在“共享”环境下容易出现读取错误的问题,使用 volatile 关键字可以防止编译器对变量的一些优化,确保每次读取变量都是从内存中读取,而不是从寄存器中读取。
使用场景:
- 多线程环境下,一个变量在多个线程之间共享时,一个线程修改了变量的值,另一个线程需要读取这个变量的最新值。
- 硬件寄存器,如中断服务程序中会使用
volatile修饰变量,因为这些变量的值可能会在程序的控制之外被修改。
示例:
点击展开
1 |
|
输出的结果是:6 5输出5的原因是:编译器对其做了优化,直接将j替换为文字常量5。
1 |
|
输出:6 6因为有volatile修饰变量,则在输出时,编译器不会对其优化,直接从地址中读取内容。
const
const 是一个类型修饰符,是 C++ 中用于声明‘只读’属性的关键字,它的核心作用是告诉编译器和开发者:被修饰的实体在初始化后其值或状态不可被修改。
- 修饰变量,说明该变量不可以被改变;
- 修饰指针,分为指向常量的指针(pointer to const)和自身是常量的指针(常量指针,const pointer);
- 修饰引用,指向常量的引用(reference to const),用于形参类型,即避免了拷贝,又避免了函数对值的修改;没有
const reference,因为引用只是对象的别名,引用不是对象,不能用 const 修饰 - 修饰成员函数,说明该成员函数内不能修改成员变量。
点击展开
1 | // 类 |
mutable
mutable 用于修饰类的非静态数据成员,使这个成员即使在 const 成员函数或者 const 对象中也可以被修改。它主要用于那些不属于对象逻辑状态、但属于实现细节的数据,例如缓存、访问计数以及 mutable std::mutex。这样可以在保持接口的 const 语义的同时,修改内部实现状态。
点击展开
1 | // 例子: 统计访问次数 |
new
new 和 malloc 都是用于动态内存分配的,但它们有一些重要的区别:
- new是操作符,而malloc是函数。
- new在调用的时候先分配内存,在调用构造函数,释放的时候调用析构函数;而malloc没有构造函数和析构函数。
- malloc需要给定申请内存的大小,返回的指针需要强转;new会调用构造函数,不用指定内存的大小,返回指针不用强转。
- new可以被重载;malloc不行
- new分配内存更直接和安全。
- new发生错误抛出异常,malloc返回null
malloc底层实现:当开辟的空间小于 128K 时,调用 brk()函数;当开辟的空间大于 128K 时,调用mmap()。malloc采用的是内存池的管理方式,以减少内存碎片。先申请大块内存作为堆区,然后将堆区分为多个内存块。当用户申请内存时,直接从堆区分配一块合适的空闲快。采用隐式链表将所有空闲块,每一个空闲块记录了一个未分配的、连续的内存地址。
new底层实现:关键字new在调用构造函数的时候实际上进行了如下的几个步骤:
- 创建一个新的对象
- 将构造函数的作用域赋值给这个新的对象(因此this指向了这个新的对象)
- 执行构造函数中的代码(为这个新对象添加属性)
- 返回新对象
inline
inline 是一个函数修饰符,用于提示编译器将函数的调用点替换为函数体的代码,从而减少函数调用的开销。内联函数通常用于小型、频繁调用的函数,以提高程序的执行效率。
为什么要使用内联函数
普通函数在调用时,CPU 需要进行保存寄存器、压栈、跳转到目标函数地址、执行完毕后再出栈并返回等一系列开销。对于只有几行代码的小函数,调用开销可能远大于函数本身的执行时间,在声明为内联函数之后:
- 相当于把内联函数里面的内容写在调用内联函数处。
- 相当于不用执行进入函数的步骤,直接执行函数体。
- 相当于宏,却比宏多了类型检查,真正具有函数特性。
- 编译器一般不内联包含循环、递归、switch 等复杂操作的内联函数。
- 在类声明中定义的函数,除了虚函数的其他函数都会自动隐式地当成内联函数。
示例代码
1 | // MathUtils.h |
extern
extern 是存储类说明符(storage-class-specifier),用于声明变量或函数具有外部链接,表示实体的定义可能在其他翻译单元中。
extern "C" 是链接指示(linkage directive),它指定函数或变量使用 C 语言链接(不影响编译规则)。
- 禁止 C++ 名称修饰。确保符号名称与该平台下 C 编译器生成的名称一致,避免链接时因名称修饰导致的未定义符号错误,但不保证平台 ABI(应用二进制接口)一致性。
- 实现 C/C++ 互操作。允许 C++ 函数被 C 代码调用(或反之)。
explicit
explicit 用于修饰构造函数,主要作用是禁止构造函数进行隐式类型转换。
默认情况下,单参数构造函数可以把其他类型隐式转换成当前类类型;加上 explicit 后,只允许显式构造,例如 A a(10) 或 A a{10},而不允许 A a = 10。这样可以避免隐式转换导致的歧义和潜在 Bug。
手撕代码
编写一个标准的 String 类
点击展开
要求:
- 实现基本的构造函数、析构函数、拷贝构造函数、移动构造函数。
- 实现赋值运算符和移动赋值运算符重载。
- 实现字符串的
c_str()方法,返回 C 风格的字符串。
点击展开
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
class String {
private:
char* m_data; // 动态分配的字符数组
public:
// 1. 默认构造函数和带参数的构造函数
String(const char* str = nullptr) {
if (str == nullptr) {
m_data = new char[1];
m_data[0] = '\0';
} else {
m_data = new char[std::strlen(str) + 1];
std::strcpy(m_data, str);
}
}
// 2. 拷贝构造函数,深拷贝
String(const String& other) {
m_data = new char[std::strlen(other.m_data) + 1];
std::strcpy(m_data, other.m_data);
}
// 3. 移动构造函数,资源偷取,标记 noexcept 让编译器知道这个函数不会抛出异常
String(String&& other) noexcept : m_data(other.m_data) {
other.m_data = nullptr; // 将原指针置空,防止二次释放
}
// 4. 析构函数
~String() {
delete[] m_data;
}
// 5. 拷贝赋值运算符
String& operator=(const String& other) {
if (this != &other) { // ① 防止自我赋值
char* new_data = new char[std::strlen(other.m_data) + 1]; // ② 先申请,保证异常安全
std::strcpy(new_data, other.m_data);
delete[] m_data; // ③ 再释放旧资源
m_data = new_data;
}
return *this;
}
// 6. 移动赋值运算符
String& operator=(String&& other) noexcept {
if (this != &other) { // ① 防止自我赋值
delete[] m_data; // ② 释放当前对象旧资源
m_data = other.m_data; // ③ 偷取资源
other.m_data = nullptr; // ④ 原指针置空
}
return *this;
}
// // 5 + 6. 统一的赋值运算符重载
// String& operator=(String other) noexcept {
// std::swap(m_data, other.m_data);
// return *this;
// }
// 7. 返回 C 风格字符串,只读并返回不可修改的指针
const char* c_str() const {
return m_data;
}
};
编写一个简单的线程池
点击展开
1 |
|
编写一个简单的有限状态机
点击展开
1 | // state_machine.hpp |
1 | // main.cpp |
设计模式
常用设计模式
点击展开
单例模式
单例模式是一种创建型设计模式,它保证一个类只有一个实例,并提供一个全局访问点。单例模式的优点包括:
-
控制实例数目:单例模式可以确保一个类只有一个实例,避免了因为多次创建实例而导致的资源浪费。
-
全局访问点:单例模式提供了一个全局访问点,这使得我们可以在任何地方都能访问到这个实例。
-
共享资源:由于单例模式只有一个实例,所以可以方便地用于共享资源,例如配置信息,缓存等。
注意,虽然单例模式有这些优点,但也有一些缺点,例如它可能导致代码的耦合度增加,且在多线程环境下需要特别注意线程安全问题。因此,在使用单例模式时需要根据具体的需求和场景进行权衡。
代理模式
代理模式是一种结构型设计模式,它提供了一个对象来代替另一个对象控制对原对象的访问。代理对象可以在客户端和目标对象之间起到中介的作用,并添加额外的功能。
代理模式主要包含以下三种类型:
-
虚拟代理:在需要时创建开销很大的对象。通过它来存储实例化需要很长时间的真实对象的一些信息。
-
保护代理:控制真实对象访问的权限。
-
远程代理:为一个对象在不同的地址空间提供局部代表。
代理模式通常包含以下几个角色:
-
抽象主题(Subject):定义了 RealSubject 和 Proxy 共用接口,这样在任何使用 RealSubject 的地方都可以使用 Proxy。
-
真实主题(RealSubject):定义了 Proxy 所代表的真实实体。
-
代理(Proxy):保存一个引用使得代理可以访问实体,并提供一个与 Subject 的接口相同的接口。
以下是一个简单的 C++ 代理模式的例子:
1 | class Subject { |
观察者模式
观察者模式是一种行为型设计模式,定义了对象之间的一对多依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都会得到通知并自动更新。
这种设计模式通常用于需要实现复杂的事件处理或消息传递系统时。例如,GUI库、游戏、实时系统、分布式系统等都可能使用观察者模式。
观察者模式有以下优点:
-
解耦:观察者模式可以解耦观察者和被观察者之间的关系,使得它们可以独立变化和复用。
-
广播通信:被观察者会向所有的观察者广播通知,这是一种一对多的关系。
-
动态关系:可以在运行时动态地添加和删除观察者,改变观察者与被观察者之间的关系。
然而,观察者模式也有一些缺点:
-
过度使用或误用:如果过度使用或误用观察者模式,可能会导致程序难以理解和维护。例如,如果一个观察者的更新操作引发了另一个更新操作,可能会导致复杂的链式更新。
-
假设同步通知:观察者模式通常假设观察者在接收到通知后能立即进行更新,但在某些情况下,这可能不是可行的。例如,如果观察者的更新操作需要很长时间,或者需要从网络获取数据,那么这种同步通知的方式可能会导致程序阻塞。
-
可能引发的性能问题:如果有大量的观察者,或者观察者的处理逻辑很复杂,那么通知所有观察者可能会花费很长时间。
拓展阅读:
如何实现一个线程安全的单例模式?
点击展开
线程安全:在拥有共享数据的多条线程并行执行的程序中,线程安全的代码会通过同步机制保证各个线程都可以正常且正确的执行,不会出现数据污染等意外情况。
单例模式指在整个系统生命周期里,保证一个类只能产生一个实例,确保该类的唯一性。
单例模式可以分为懒汉式和饿汉式,两者之间的区别在于创建实例的时间不同:
懒汉式:指系统运行中,实例并不存在,只有当需要使用该实例时,才会去创建并使用实例。(这种方式要考虑线程安全)饿汉式:指系统一运行,就初始化创建实例,当需要时,直接调用即可。(本身就线程安全,没有多线程的问题)
如何实现线程安全:
普通的懒汉式单例没有加锁,是线程不安全的,当线程并发时会创建多个实例。
1 |
|
加锁的懒汉式单例,std::unique_lock<std::mutex> lock(m_Mutex);加了互斥锁的普通懒汉式是线程安全的。
1 |
|
双重检查锁定的懒汉单例,通过在实例化单例对象时进行双重检查来避免了不必要的加锁,从而提高了一定的性能。
1 |
|
内部静态变量的懒汉单例,利用了局部静态变量的初始化是线程安全的这一特性,因为C++11保证了局部静态变量的初始化在并发情况下只会被执行一次,线程安全,且不需要使用锁,因此性能最好。
1 |
|
参考链接:
操作系统
死锁的「产生」「预防」「避免」「检测」「解除」
点击展开
产生
死锁是多个并发进程因争夺系统资源而产生相互等待的现象。死锁通常是由于多个进程之间的资源竞争和进程间的不恰当同步造成的。
死锁的产生需要满足四个必要条件:
- 互斥条件:一个资源每次只能被一个进程访问。
- 占有与等待条件:一个进程因请求资源而阻塞时,对已获得的资源保持不释放。
- 不可抢占条件:进程 A 已获得的资源,在未使用完之前,不能被 B 强行剥夺。
- 循环等待条件:每个进程都在等待其他进程所占有的资源,形成一个环路。
上面四个条件同时成立时,系统就会发生死锁,缺少其中任何一个条件,死锁都不会发生。
预防
预防死锁就是破坏上面四个条件任意一个,但是实现很难:
- 破坏互斥条件:允许某些资源同时被多个进程访问。但是有些资源本身并不具有这种属性,因此这种方案实用性有限。
- 破坏占有并等待条件:但下列两种方案的缺点是很多时候无法预知一个进程所需的全部资源,同时会降低资源利用率、降低系统的并发性。
- 实行资源预先分配策略,当一个进程开始运行之前,必须一次性向系统申请它所需要的全部资源,否则不运行;
- 只允许进程在没有占用资源的时候才能申请资源,即申请资源前先释放占有的资源。
- 破坏不可抢占条件:允许进程强行抢占被其它进程占有的资源。会降低系统性能。
- 破坏循环等待条件:采用资源有序分配的思想,将系统中的所有资源顺序编号,将紧缺的稀少的采用较大的编号,在申请资源时必须按照编号的顺序进行(从小往大申请),一个进程只有获得较小编号的进程才能申请较大编号的进程,这样就不会形成环路,从而能预防死锁的发生。
避免
允许系统中同时存在四个必要条件,但是每当进程提出资源申请时,系统要分析满足该资源请求后,系统是否会发生死锁,若不会发生则实施分配,否则拒绝分配,即在使用前进行判断,只允许不会产生死锁的进程申请资源。银行家算法实现了这个过程。
银行家算法(Banker's Algorithm)
1 | 银行家算法是操作系统中用于避免死锁(Deadlock)的经典资源分配算法,由荷兰计算机科学家艾兹赫尔·戴克斯特拉(Edsger Dijkstra)于1965年提出。 |
检测
画出资源分配图,检测是否存在环路。检测环路前要将资源分配图化简,化简的原理是“一个目前占有运行所需的资源的进程,迟早能够执行完成释放资源”。因此,可以从“进程—资源分配图”中找到一个既不阻塞又非孤立的进程,删除所有与该进程相连的有向边,回收资源,使之成为孤立结点,然后将所回收的资源分配给其它进程。循环此过程,直到无法化简。若仍存在环路,则该系统目前处于死锁状态。
检测到死锁后,需要解除死锁。
解除
破坏除了“互斥条件”之外的其他三个条件:
- 回退执行:系统定期对各个进程进行检查,将检查点的有关信息写入文件。死锁时,让某占有必要资源的进程回退到取得资源之前的一个检查点,释放的资源分配给一个死锁进程(破坏“占有且等待”)
- 抢占资源:剥夺占有进程的资源,分配给另外某些进程,直至死锁环路被打破(破坏“不可抢占”)
- 杀掉进程:一次终止一个进程,直至消除死锁环路(破坏“循环等待”)
拓展阅读:
虚拟地址映射到物理地址的过程
点击展开
物理地址和虚拟地址是操作系统内存管理中的两个重要概念。
-
物理地址: 物理地址是实际存储在计算机内存芯片上的地址,也称为实际地址或真实地址。它是硬件所理解和处理的地址,用于直接访问计算机的内存单元。
-
虚拟地址: 虚拟地址是由处理器(CPU)生成的地址,用于访问计算机内存中的数据。它是相对于程序而言的一种抽象地址,程序只能看到和使用虚拟地址,而不知道实际的物理内存地址。虚拟地址空间通常比物理内存空间大得多,因为它可以包含操作系统和其他应用程序的地址空间。
为什么要将虚拟地址映射到物理地址?
- Why?:将虚拟地址映射到物理地址的主要目的是实现内存管理和地址空间隔离。通过虚拟地址,操作系统可以为每个程序提供独立的地址空间,使得每个程序都认为自己拥有整个内存空间,从而实现了地址空间的隔离和保护。
什么时候会发生虚拟地址到物理地址之间的映射?
- When?:虚拟地址到物理地址的映射通常发生在计算机执行程序时进行内存访问时。具体来说,当程序访问内存中的数据时,处理器会生成虚拟地址,并通过硬件中的地址转换单元(MMU)将虚拟地址映射到物理地址。
谁来处理虚拟地址到物理地址的映射?
- Who?:虚拟地址到物理地址的映射是由硬件中的地址转换单元(MMU)来处理的。MMU是计算机体系结构中的一个重要组成部分,负责处理内存访问请求,并将虚拟地址映射到物理地址。
如何处理虚拟地址到物理地址的映射?
- How?:虚拟地址到物理地址的映射过程通常包括以下几个步骤:
- 页表查找: MMU根据虚拟地址的高位页号来查找页表。
- 页表项解析: 一旦找到了页表中对应的页表项,MMU会解析该项以获取物理地址页面帧号。
- 偏移量添加: MMU将虚拟地址中的偏移量与物理地址页面帧号相结合,得到最终的物理地址。
- TLB缓存(可选): 为了加速地址转换过程,MMU可能会使用一个高速缓存,称为翻译后备缓冲器(TLB)。TLB中存储了最近的一些虚拟地址到物理地址的映射关系,如果TLB中找到了对应的映射,MMU会直接使用它而不必查询页表。
- 缺页处理(可选): 如果在查询页表或TLB时发现对应的页面不在内存中(即缺页),则会触发一个缺页中断。在这种情况下,操作系统会将缺失的页面从磁盘加载到内存中,并更新页表或TLB以反映这个变化。
总的来说,虚拟地址到物理地址的映射是由硬件中的MMU处理的,它通过页表查找、解析页表项、偏移量添加等步骤完成映射过程。TLB缓存和缺页处理是在这个过程中的一些优化和异常处理机制。
参考文档:
计算机网络
网络分层模型
点击展开
网络分层是将复杂的网络通信功能模块化的一种设计方法,通常将网络通信过程划分为若干层,每一层都提供特定的功能,通过接口与相邻层进行交互。常见的网络分层模型有OSI七层模型和TCP/IP四层模型。
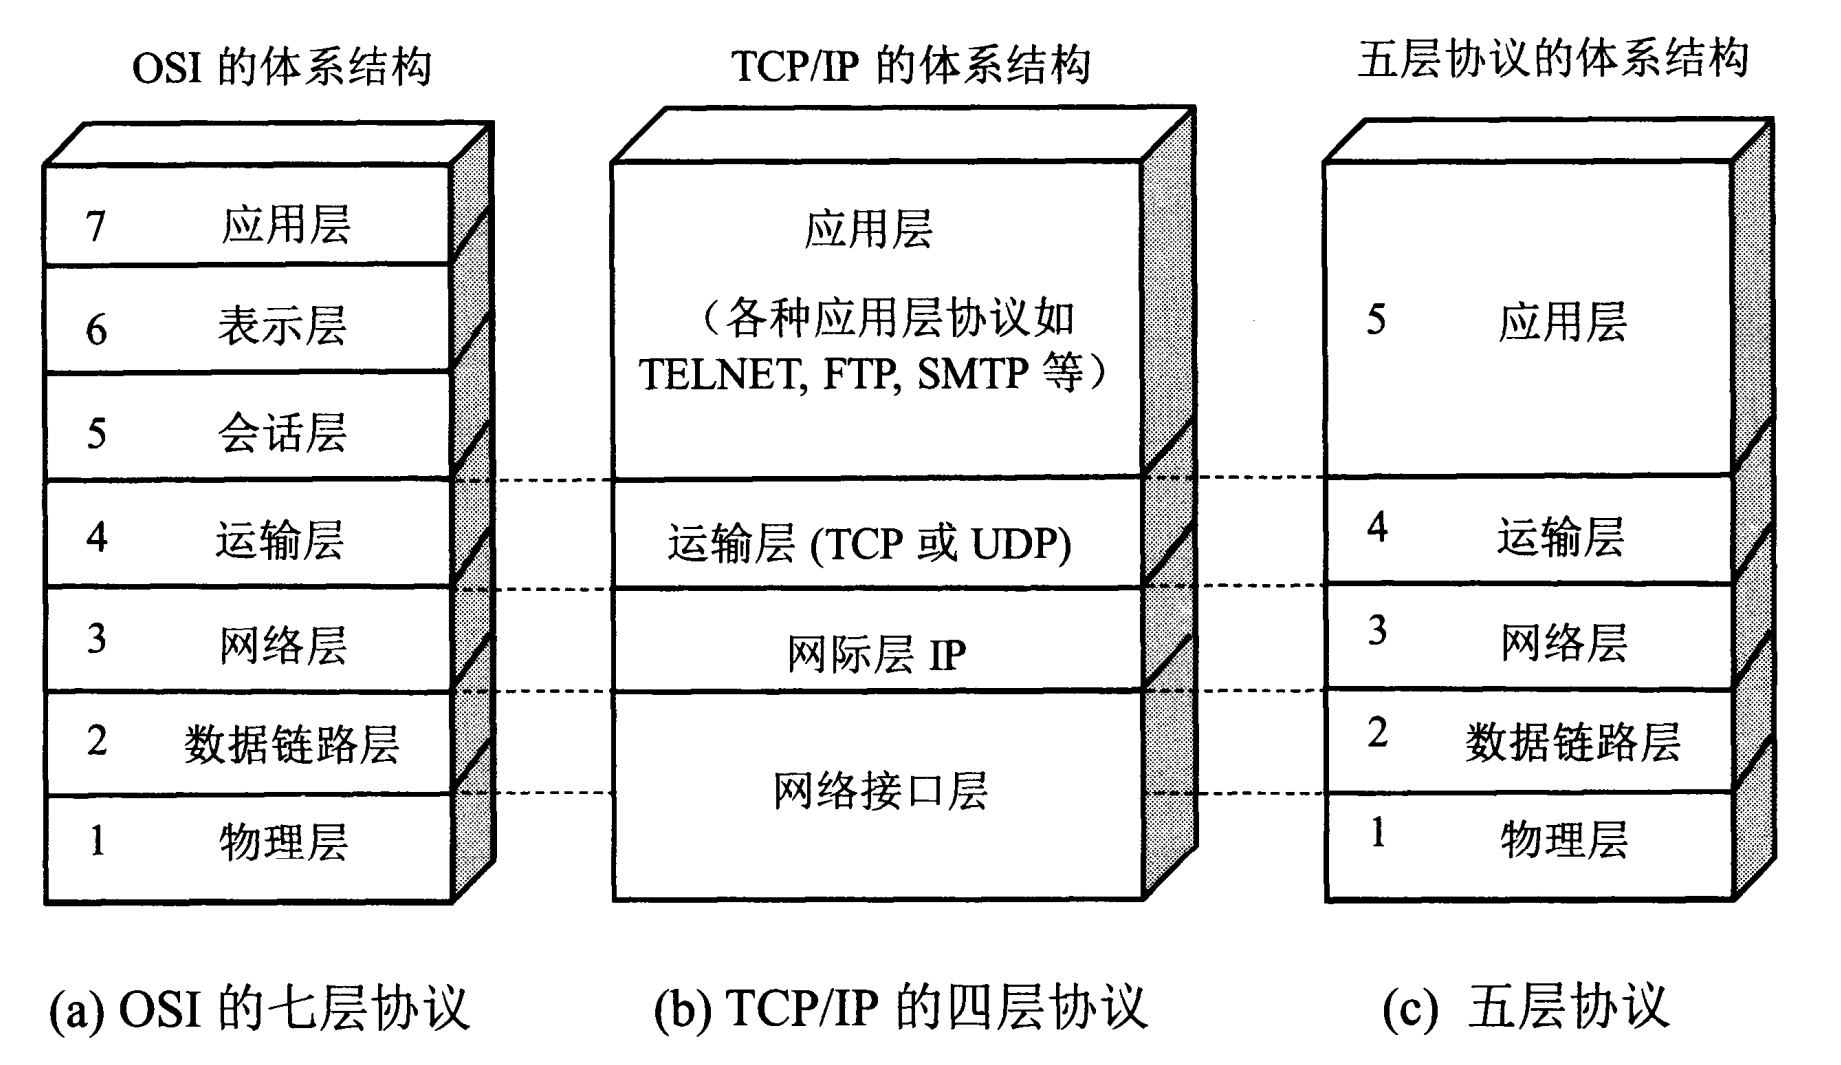
OSI七层模型是理论模型,TCP/IP四层模型是实际被广泛应用的模型,因此在CS专业的学习中往往采取折中的方法,即综合OSI和TCP/IP模型的优点,形成上图中的五层模型,这样既简洁又能将概念理解清楚,但需要注意的是五层模型并不是一个标准的网络分层模型,实际应用还是以TCP/IP四层模型为主。
OSI七层模型
OSI 从上到下分为 7 层:
- 应用层:定义应用进程间的通信和交互的规则,不同的网络应用需要不同的应用层协议
- 表示层:把数据转换为能与接收者的系统格式兼容并适合传输的格式
- 会话层:在数据传输中设置和维护电脑网络中两台电脑之间的通信连接
- 传输层:向两台主机进程之间的通信提供通用的数据传输服务
- 网络层:基于网络层地址(IP地址)进行不同网络系统间的路径选择
- 数据链路层:在不可靠的物理介质上提供可靠的传输
- 物理层:在局域网上透明地传送比特,尽可能屏蔽掉具体传输介质和物理设备的差异
TCP/IP四层模型
从上到下分为 4 层,对应于 OSI 中的 5 层:
- 应用层:对应 OSI 参考模型的应用层,定义的是应用进程间的通信和交互的规则,不同的网络应用需要不同的应用层协议。
- 传输层:对应 OSI 参考模型的传输层,为应用层实体提供端到端的、通用的通信功能,保证了数据包的顺序传送及数据的完整性。“通用的”是指不同的应用可以使用同一个运输层服务。
- 网络层:对应 OSI 参考模型的网络层,主要解决主机到主机的路由问题。
- 网络接口层:对应 OSI 参考模型的物理层和数据链路层,负责相邻物理节点间可靠数据传输。
各层功能速查表
| OSI | TCP/IP | 主要功能 | 数据单位 | 典型协议 | 典型设备 |
|---|---|---|---|---|---|
| 应用层 | 应用层 | 为应用进程提供网络服务,定义进程间通信与交互的规则 | 报文 | HTTP、HTTPS、FTP、SMTP、DNS、Telnet | — |
| 表示层 | 应用层 | 数据格式转换、编解码、加密解密、压缩解压 | 报文 | ASCII、JPEG、SSL/TLS | — |
| 会话层 | 应用层 | 建立、管理和终止通信会话 | 报文 | RPC、NetBIOS | — |
| 传输层 | 传输层 | 提供端到端的进程间通信,可靠传输、流量控制与拥塞控制 | 报文段 | TCP、UDP | 网关 |
| 网络层 | 网络层 | 逻辑寻址(IP 地址)、路由选择与分组转发 | 分组/数据报 | IP、ICMP、IGMP、OSPF、RIP、BGP | 路由器 |
| 数据链路层 | 网络接口层 | 将比特组装成帧,MAC 寻址与差错检测 | 帧 | Ethernet、PPP、HDLC、IEEE 802.11 | 交换机、网桥 |
| 物理层 | 网络接口层 | 透明地传送比特流,屏蔽传输介质与物理设备的差异 | 比特 | RS-232、RJ-45 | 中继器、集线器 |
要点:
- OSI 上三层(应用、表示、会话)在 TCP/IP 中合并为应用层;OSI 下两层(数据链路、物理)在 TCP/IP 中合并为网络接口层。教材中常用的五层模型则保留数据链路层与物理层,即:应用层、传输层、网络层、数据链路层、物理层。
- 寻址层级速记:传输层及以上按端口寻址(进程),网络层按 IP 地址寻址(主机),数据链路层按 MAC 地址寻址(网卡)。
- 数据封装时自上而下逐层添加首部(报文 → 报文段 → 分组 → 帧 → 比特流),接收时自下而上逐层解封装。
- ARP 用于将 IP 地址解析为 MAC 地址,工作于网络层与数据链路层之间。一种说法是属于网络层,因为 IP 协议使用 ARP 协议;另一种说法是属于数据链路层,因为 MAC 地址是数据链路层的内容。在 OSI 模型中,ARP 协议属于链路层;而在 TCP/IP 模型中,ARP 协议属于网络层。
三次握手和四次挥手
点击展开
TCP/IP协议中的三次握手和四次挥手是建立和关闭TCP连接时的重要过程。三次握手用于安全建立双向连接,四次挥手用于完整释放双向连接。这些过程确保了在TCP连接的建立和关闭过程中,双方都能够正确地进行通信并进行必要的确认和处理,以保证数据的可靠传输。
三次握手(Three-Way Handshake):
作用:
- 确认收发能力:明确双方的发送和接收能力都正常。
- 同步初始序列号:交换并确定双方的初始序列号,保证后续数据传输的有序性和可靠性,防止数据乱序、重复。
- 防止历史连接:避免已失效的旧连接请求突然又传到服务器,导致服务器错误分配资源。
步骤:
-
客户端向服务器发送连接请求(SYN): 客户端发送一个带有SYN(同步序列编号)标志的TCP数据包给服务器,说明客户端要建立连接,并选择一个初始序列号。
-
服务器响应连接请求(SYN + ACK): 如果服务器同意连接,会发送一个带有SYN和ACK(确认)标志的TCP数据包给客户端,以确认客户端的连接请求,并选择一个初始序列号作为回应。
-
客户端确认连接(ACK): 最后,客户端再发送一个带有ACK标志的数据包给服务器,表示连接请求已收到确认。此时,TCP连接已经建立,双方可以开始进行数据传输。
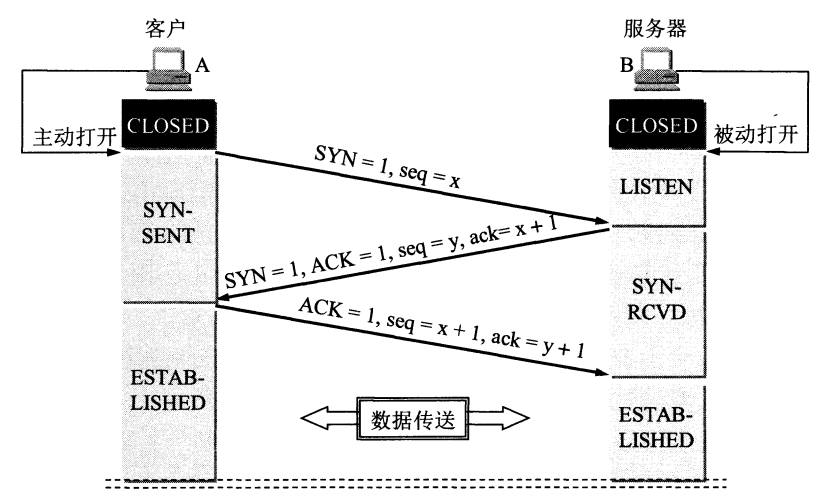
RFC 973 (TCP 规范) 中关于三次握手的描述是 three way handshake,而不是 three times handshake 或 three way handshakes。可见,三次握手其实是在一次握手的过程中交换了三个报文,而不是进行了三次握手。这有点像两个人见面进行一次握手时,他们的手上下摇晃三次,但这并不意味着他们进行了三次握手。
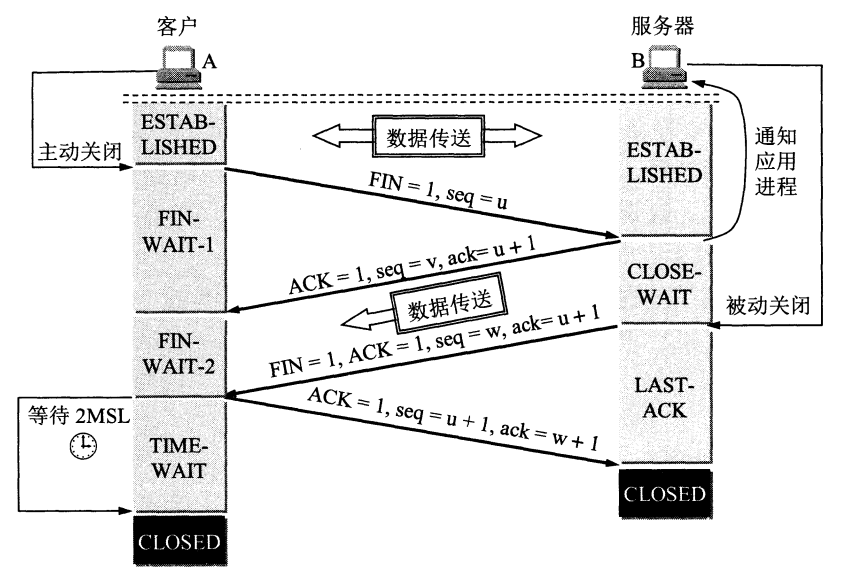
四次挥手(Four-Way Handshake):
作用:
- 适应全双工关闭:TCP 连接是全双工的(双向都可以发数据)。当一方主动请求关闭、停止发送数据时,另一方可能还有数据要发送。因此,确认收到关闭请求(ACK)和自己决定关闭(FIN)通常是分开的,需要四个步骤。
- 确保数据完整传输:保证双方在释放连接前,把各自剩余的数据安全发送和接收完毕,防止数据丢失。
- 完全释放资源:确保双方都彻底同意关闭,回收操作系统的内核连接资源。
步骤:
-
发起关闭连接请求(FIN): 当客户端或服务器决定关闭连接时,会发送一个带有FIN(结束)标志的TCP数据包给对方,表示不再向对方发送数据。
-
对关闭请求进行确认(ACK): 收到关闭请求的一方会发送一个带有ACK标志的TCP数据包作为确认,表示收到了关闭请求。
-
关闭连接(FIN): 接收到关闭请求并确认后,对方也会发送一个带有FIN标志的TCP数据包给发起关闭的一方,表示同意关闭连接。
-
确认关闭(ACK): 最后,发起关闭的一方收到对方的确认后,也会发送一个带有ACK标志的TCP数据包给对方,表示确认收到关闭请求。此时,TCP连接彻底关闭,双方不再传输数据。
参考链接:
TCP 与 UDP 的对比
点击展开
| 方面 | TCP | UDP |
|---|---|---|
| 连接性 | 面向连接 | 无连接 |
| 可靠性 | 提供可靠的数据传输 | 不提供可靠性保证 |
| 传输方式 | 面向字节流 | 面向数据报 |
| 传输距离 | 适用于局域网和广域网 | 适用于局域网 |
| 双工性 | 全双工 | 可以是全双工、半双工或单工 |
| 流量控制/拥塞控制 | 提供流量控制和拥塞控制 | 不提供流量控制和拥塞控制 |
| 应用场景 | 网页浏览、文件传输、电子邮件等 | 音频、视频流媒体、在线游戏等 |
| 应用层协议 | HTTP、HTTPS、FTP、SMTP等 | DNS、DHCP、TFTP、SNMP等 |
POST 和 GET 的区别
点击展开
| 方面 | POST | GET |
|---|---|---|
| 数据位置 | 请求体中发送数据 | URL中发送数据 |
| 数据长度限制 | 无限制 | 有限制(通常受浏览器或服务器限制 2KB) |
| 安全性 | 更安全,数据不会暴露在URL中 | 较不安全,数据会暴露在URL中 |
| 应用 | 添加 / 修改服务器的数据 | 获取服务器的指定数据 |
| 历史记录 | 不可以 | 可以保存在历史记录中或者收藏为书签 |
| 缓存 | 不可被缓存 | 可以被缓存 |
| 数据类型 | 可以发送多种类型的数据(二进制、文本等) | 仅能发送ASCII字符 |
| 请求类型 | 用于向服务器提交数据,用于创建资源 | 用于从服务器获取数据,用于读取资源 |
| 幂等性 | 非幂等,会对服务器资源进行改变 | 幂等(同样的请求发送多次会产生相同的结果) |
| 安全性 | 需要一定的安全性措施 | 相对较不需要安全性措施 |
| 可见性 | 数据不会暴露在URL中 | 数据会暴露在URL中 |
| 后退 / 刷新 | 后退或者刷新的时候,GET是无害的 | 后退或者刷新的时候,POST会重新提交表单 |
RESTful 接口
点击展开
RESTful 是一种基于 REST 架构风格设计 Web API 的设计理念和风格。它强调以资源为核心,将 Web 应用程序建模为资源,并通过 HTTP 的标准方法对资源进行操作
RESTful架构风格强调以下几个关键特征:
-
资源(Resources): 将网络上的信息(如文档、图片、视频等)视为资源,并使用URI(统一资源标识符)来唯一标识每个资源。
-
表现层状态转换(Representational State Transfer): 客户端和服务器之间的交互通过表现层的转换来实现,客户端通过操作资源的表现形式来操作资源。
-
无状态(Stateless): 服务端不保存客户端的状态信息,每个请求都包含足够的信息,使服务器可以理解请求的上下文。
-
统一接口(Uniform Interface): 使用统一的接口对资源进行操作,包括标识资源的URI、使用标准的HTTP方法(GET、POST、PUT、DELETE等)进行操作、使用标准的媒体类型(如JSON、XML)来传输资源的表现形式。
-
客户端-服务器架构(Client-Server): 将系统划分为客户端和服务器,客户端负责用户界面和用户交互,服务器负责存储和管理资源。
-
可缓存性(Cacheability): 服务端必须声明哪些资源是可缓存的,客户端可以使用缓存来提高性能和减少网络延迟。
-
分层系统(Layered System): 允许系统在不影响客户端的情况下增加中间层(如代理服务器、负载均衡器等),以提高系统的可伸缩性和性能。
幂等性:一个请求执行一次和执行多次,对服务器最终状态产生的效果相同。
| Method | 典型用途 | 是否幂等 |
|---|---|---|
| GET | 获取资源 | 是 |
| POST | 创建资源/提交操作 | 否 |
| PUT | 整体更新/替换资源 | 是 |
| PATCH | 部分更新资源 | 通常可设计为幂等 |
| DELETE | 删除资源 | 是 |
HTTP 状态码,2xx:成功、 3xx:重定向、4xx:客户端错误、5xx:服务器错误
| 状态码 | 名称 | 含义 |
|---|---|---|
| 200 | OK | 请求成功 |
| 201 | Created | 资源创建成功 |
| 202 | Accepted | 请求已接受,异步处理中 |
| 204 | No Content | 成功,但无响应 Body |
| 301 | Moved Permanently | 永久重定向 |
| 302 | Found | 临时重定向 |
| 304 | Not Modified | 资源未修改,使用缓存 |
| 400 | Bad Request | 请求参数/格式错误 |
| 401 | Unauthorized | 未认证 |
| 403 | Forbidden | 已认证但无权限 |
| 404 | Not Found | 资源不存在 |
| 405 | Method Not Allowed | HTTP 方法不允许 |
| 408 | Request Timeout | 请求超时 |
| 409 | Conflict | 请求与当前资源状态冲突 |
| 413 | Content Too Large | 请求体太大 |
| 415 | Unsupported Media Type | 不支持的媒体类型 |
| 422 | Unprocessable Content | 请求格式正确,但语义/业务校验失败 |
| 429 | Too Many Requests | 请求过于频繁/限流 |
| 500 | Internal Server Error | 服务器内部错误 |
| 501 | Not Implemented | 服务端不支持该功能 |
| 502 | Bad Gateway | 网关从上游收到无效响应 |
| 503 | Service Unavailable | 服务暂时不可用 |
| 504 | Gateway Timeout | 网关等待上游超时 |
TCP 保证可靠传输的核心机制
点击展开
TCP 作为可靠传输协议,“可靠”不是一句抽象承诺,而是一组具体机制共同配合出来的结果。
丢包要重传,乱序要重排,接收方处理不过来要流量控制,网络拥塞时要主动降速。把这些机制串起来,才能真正理解 TCP 为什么能在不可靠的 IP 网络之上实现“无差错、不丢失、不重复、按序到达”的可靠字节流传输:
-
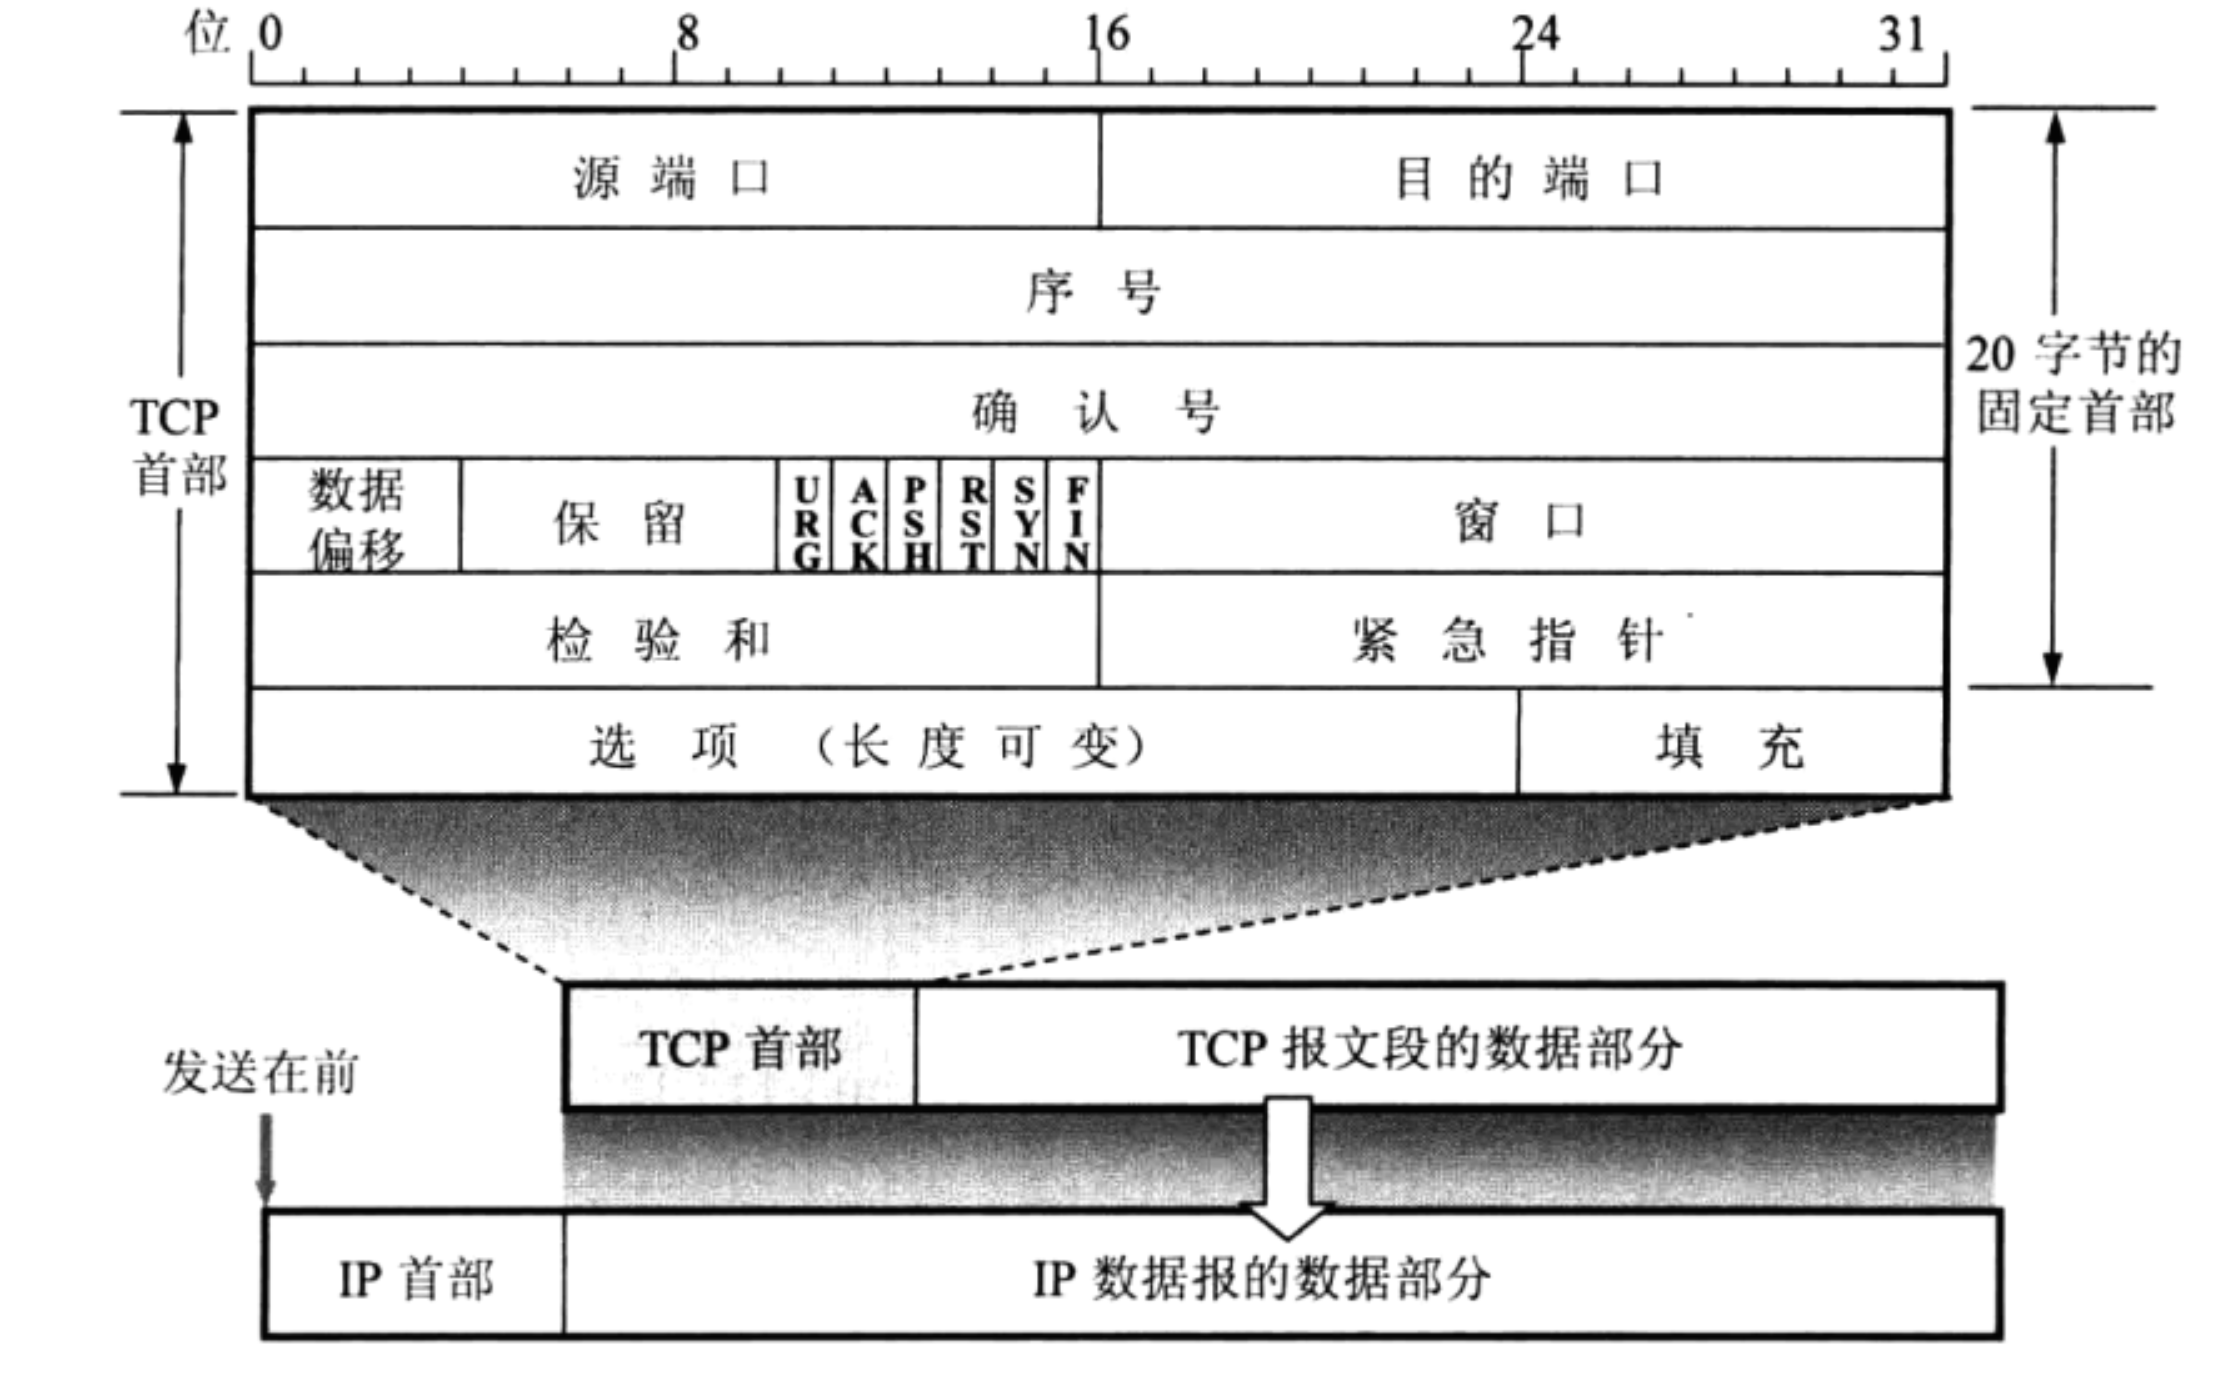
基于数据块传输 应用层数据被 TCP 分割成最适合发送的数据块,再交给网络层,每个报文段都带有首部信息(源端口、目的端口、序号、确认号、标志位、窗口大小、校验和等),便于接收端正确处理。
-
序列号和 ACK 确认数据状态 TCP 按字节给数据流编号(注意不是按报文段编号)。 接收端根据序号区间完成乱序重排、丢弃重复数据,并通过通过 ACK 告诉发送方哪些数据已经收到。 发送方据此判断哪些数据还在路上、哪些数据需要继续等待,最终向上层交付有序、无重复的字节流。
-
校验和 对 TCP 首部、数据以及 IP 伪首部计算 16 位一补和校验和,检测传输过程中的错误。 校验失败则直接丢弃该报文段,不发送确认,最终触发重传。
-
重传机制
- 超时重传:发送后启动计时器,超时未收到 ACK 则重传。
- 快速重传:连续收到 3 个重复 ACK 时,立即重传丢失段,不等超时。
- SACK:选择确认,在 ACK 中携带已收到的非连续数据块范围,让发送方只重传真正缺失的部分。
- D-SACK:额外告知发送方哪些数据被重复接收,帮助判断是否为“误重传”(如 ACK 丢失、乱序、定时器过早触发),避免不必要的拥塞误判。
-
流量控制 接收端通过接收窗口(rwnd)实时通告自己还能接收多少数据。 发送端据此限制发送速率,防止接收缓冲区溢出导致丢包。
-
拥塞控制 发送端同时考虑两个窗口:
- 接收窗口 rwnd(接收方能力)
- 拥塞窗口 cwnd(网络拥塞程度) 实际发送窗口 = min(rwnd, cwnd)。 根据上述窗口估计网络承载能力,在慢开始、拥塞避免、快速重传、快恢复以及 CUBIC、BBR 等算法的配合下,尽量避免把过多数据注入网络。当网络出现拥塞时主动降低发送速率,减少丢包,间接保障可靠性。
所谓拥塞控制是防止过多的数据注入到网络中,这样可以使网络中的路由器或链路不致过载,是一个全局性的概念;而流量控制是点到点的通信量的控制,是一个端到端的问题,移植发送端发送速度的速率,以便接收端来得及接收。
一句话总结
TCP 通过字节序号 + 累积/选择确认 + 超时/快速重传 + 校验和保证数据正确到达,再通过滑动窗口流量控制和拥塞控制防止过载丢包,共同实现可靠传输。
TCP/IP 各层常见协议
点击展开
| TCP/IP 层 | 协议 | 作用 |
|---|---|---|
| 应用层 | HTTP | 超文本传输协议(HyperText Transfer Protocol),用于 Web 客户端与服务器之间传输数据。 |
| 应用层 | HTTPS | 基于 TLS 加密的 HTTP,用于提供机密性、完整性和身份认证。 |
| 应用层 | TLS | 传输层安全协议(Transport Layer Security),为上层应用提供加密、完整性保护和身份认证。通常位于应用层协议与 TCP/UDP 等传输协议之间。 |
| 应用层 | DNS | 域名系统(Domain Name System),用于域名与 IP 地址之间的解析。 |
| 应用层 | DHCP | 动态主机配置协议(Dynamic Host Configuration Protocol),用于自动获取 IP 地址、网关、DNS 等网络配置。 |
| 应用层 | FTP | 文件传输协议(File Transfer Protocol),用于客户端与服务器之间进行文件传输。 |
| 应用层 | SSH | 安全外壳协议(Secure Shell),用于加密的远程登录、命令执行和文件传输。 |
| 应用层 | SMTP | 简单邮件传输协议(Simple Mail Transfer Protocol),用于电子邮件发送和邮件服务器之间的邮件传输。 |
| 应用层 | WebSocket | 提供客户端与服务器之间的全双工长连接通信。 |
| 应用层 | MQTT | 消息队列遥测传输协议,采用发布/订阅模型,常用于物联网设备通信。 |
| 传输层 | TCP | 传输控制协议(Transmission Control Protocol),面向连接、可靠、有序地传输字节流,并提供流量控制和拥塞控制。 |
| 传输层 | UDP | 用户数据报协议(User Datagram Protocol),无连接、面向数据报,开销小,但协议本身不保证可靠性和顺序。 |
| 传输层 | QUIC | 基于 UDP 的现代传输协议,提供可靠传输、拥塞控制、加密和连接迁移等能力,HTTP/3 基于 QUIC。 |
| 网际层 | IP | 网际协议(Internet Protocol),负责 IP 寻址、数据分组、路由和转发。 |
| 网际层 | ICMP | 互联网控制消息协议,用于网络诊断、错误报告和控制信息传递,例如 ping。 |
| 网际层 | IGMP | 互联网组管理协议,用于管理 IPv4 主机与组播组之间的成员关系。 |
| 网际层 | RIP | 路由信息协议,基于距离向量算法的内部网关协议。 |
| 网际层 | OSPF | 开放式最短路径优先,基于链路状态算法的内部网关协议。 |
| 网际层 | BGP | 边界网关协议,用于不同自治系统(AS)之间交换路由信息。 |
| 网络接口层 | ARP | 地址解析协议,用于在 IPv4 局域网中根据 IP 地址解析对应的 MAC 地址。 |
| 网络接口层 | Ethernet | 以太网,规定有线局域网中的帧格式、MAC 地址和数据链路层通信方式。 |
| 网络接口层 | Wi-Fi / IEEE 802.11 | 无线局域网标准,规定无线通信的物理层和 MAC 层机制。 |
| 网络接口层 | PPP | 点对点协议,用于两个网络节点之间的点对点链路通信。 |
一个Web页面请求全过程
点击展开
从浏览器键入URL到显示网页经历的一系列事件
-
根据域名,进行 DNS 域名解析:当用户在浏览器中输入一个 URL(例如
www.google.com)时,浏览器首先需要将域名转换为 IP 地址,这一步骤称为 DNS 解析。浏览器会查询本地缓存、操作系统缓存、路由器缓存,最后查询 DNS 服务器,直到找到对应的 IP 地址。 -
拿到解析的 IP 地址,建立 TCP 连接:一旦 DNS 解析成功并获得 IP 地址,浏览器会使用该 IP 地址与目标服务器建立 TCP 连接。这个过程包括三次握手:(1) 客户端发送 SYN(同步)包到服务器、(2) 服务器回应 SYN-ACK(同步-确认)包、(3) 客户端发送 ACK(确认)包,连接建立。
-
向 IP 地址,发送 HTTP 请求:TCP 连接建立后,浏览器会向服务器发送 HTTP(或 HTTPS)请求。这个请求包含了请求方法(如 GET、POST)、请求头(如 User-Agent、Accept)以及请求的资源路径(如
/index.html)。 -
服务器处理请求:服务器接收到 HTTP 请求后,会根据请求的内容进行处理。服务器可能会查询数据库、执行应用逻辑、读取文件系统等,以生成响应内容。处理完成后,服务器会准备好 HTTP 响应。
-
返回响应结果:服务器将处理结果封装成 HTTP 响应,并通过 TCP 连接发送回客户端。HTTP 响应包含状态码(如 200 OK、404 Not Found)、响应头(如 Content-Type、Content-Length)以及响应体(如 HTML 文档、JSON 数据)。
-
关闭 TCP 连接:在 HTTP/1.0 中,服务器在发送完响应后会关闭 TCP 连接。在 HTTP/1.1 中,默认启用了持久连接(Keep-Alive),允许复用同一个连接进行多次请求-响应对话,但在一定的空闲时间后也会关闭连接。
-
浏览器解析 HTML:浏览器接收到服务器返回的 HTML 文档后,会开始解析 HTML 内容。解析过程中,浏览器会构建 DOM 树,并根据 HTML 标签加载其他资源(如 CSS、JavaScript、图片)。
-
浏览器布局渲染:在解析 HTML 和加载资源的过程中,浏览器会根据 CSS 构建渲染树(Render Tree),计算每个元素的布局(Layout),并将到屏幕上。这个过程包括以下步骤:(1) 构建渲染树:将 DOM 树和 CSSOM 树结合,生成渲染树。(2) 布局:计算每个元素的位置和大小。(3) 绘制:将元素绘制到屏幕上。
Socket 编程
点击展开
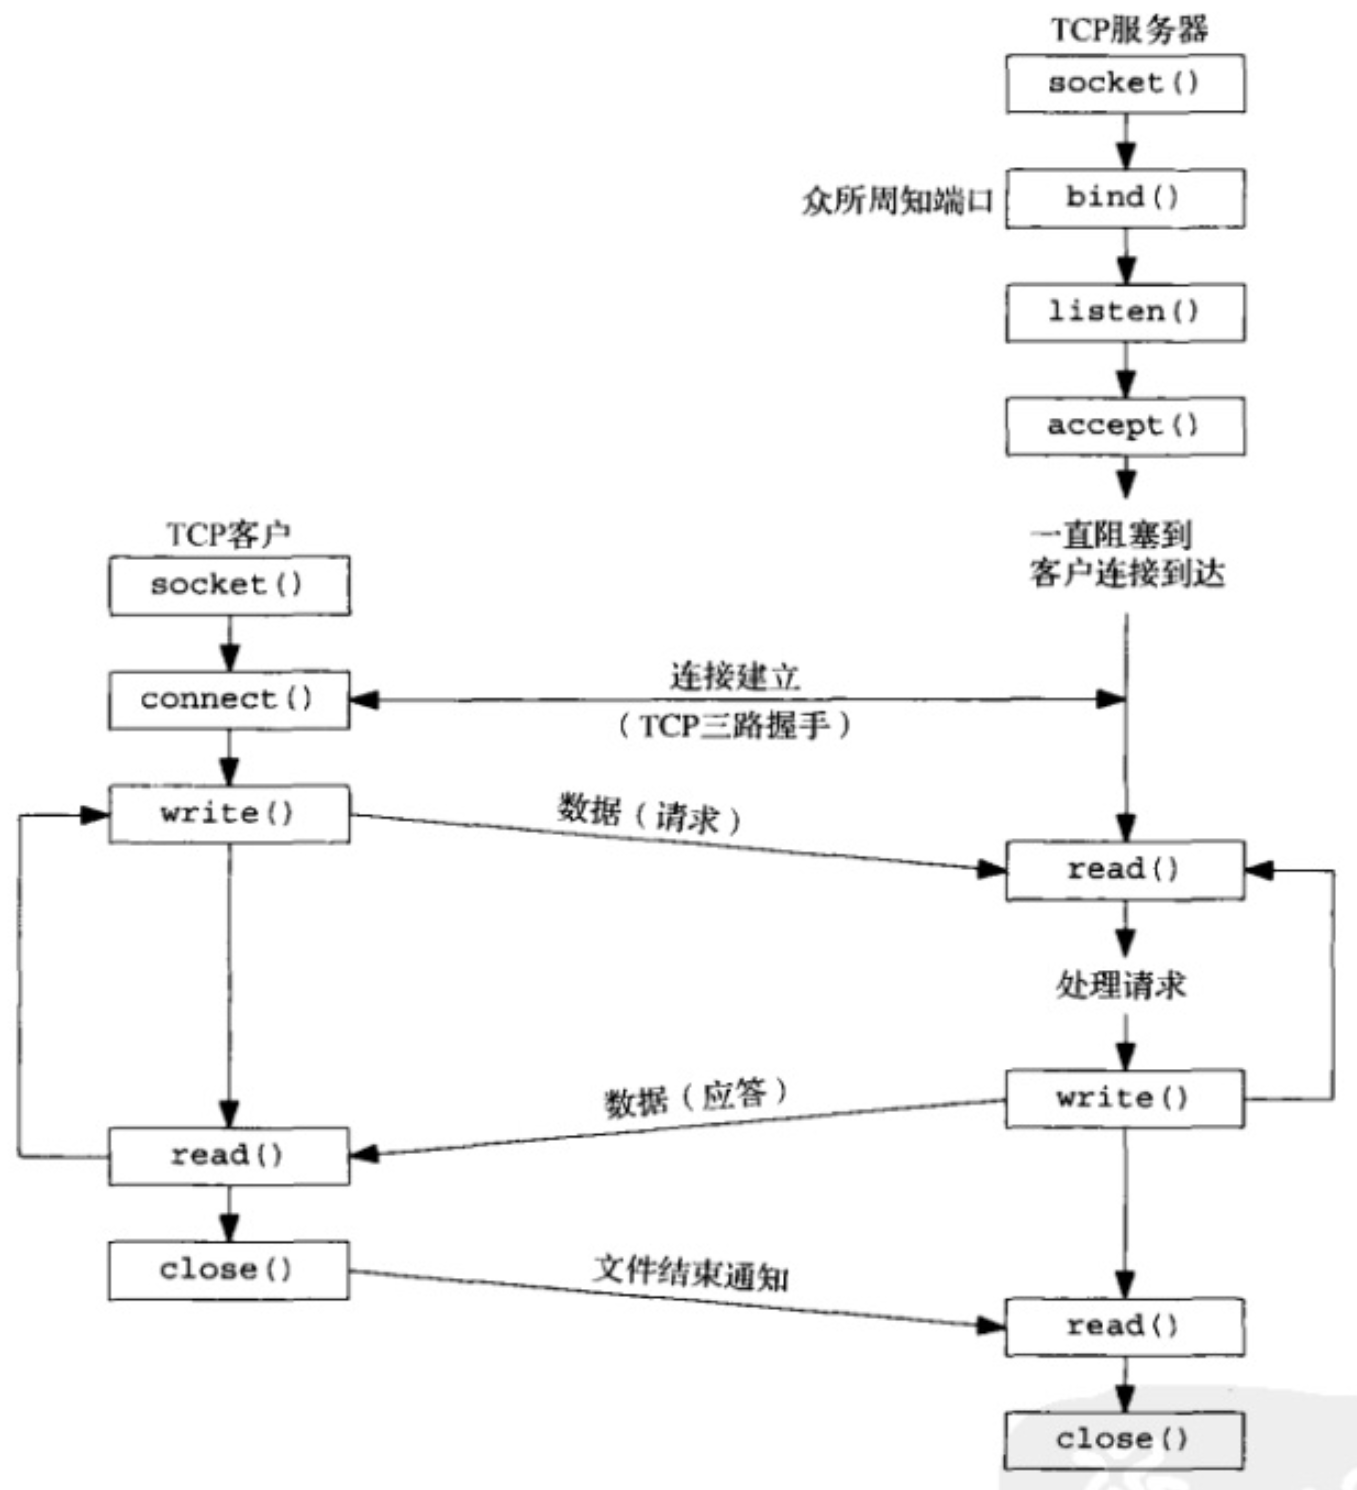
Socket 是应用层与传输层之间的编程接口,是操作系统提供给程序进行网络通信的抽象 API,通过它读写数据就像读写文件一样,形象的比喻为网络的“插座”,程序插上它就能收发数据。
基本 API 调用流程如下:
1 | 服务器端(TCP): |
代码示例:https://github.com/sitjac/code-snippets/tree/master/tutorials/cpp/socket
| 特性 / 步骤 | TCP (SOCK_STREAM) | UDP (SOCK_DGRAM) |
|---|---|---|
| 通信机制 | 面向连接、流式传输、保证顺序与到达 | 无连接、数据包(Datagram)、不可靠传输 |
| 服务端准备 | socket() bind() listen() accept() |
socket() bind() |
| 客户端准备 | socket() connect() |
socket() |
| 数据收发 | send() / recv() |
sendto() / recvfrom() |
数据结构和算法
堆排序「建堆」「调整」和「删除」的过程
点击展开
建堆、调整和删除是堆操作的三个主要步骤。以下是这三个步骤的简要描述:
-
建堆:建堆是将一个无序的数组构建成一个堆的过程。对于一个完全二叉树(堆就是一个完全二叉树),从最后一个非叶子节点开始,对每一个非叶子节点进行下沉操作(即调整操作),直到根节点。这个过程是O(n)的复杂度。
-
调整:调整是保持堆属性的过程。对于大顶堆,如果某个节点的值小于其子节点,那么就需要将这个节点和它的最大的子节点进行交换,然后继续对交换后的子节点进行调整,直到这个节点的值大于其所有子节点的值。对于小顶堆,调整的过程类似,只是比较和交换的条件相反。
-
删除:删除通常是删除堆顶元素。删除堆顶元素后,为了保持堆的属性,通常的做法是将最后一个元素移动到堆顶,然后进行调整。这个过程是O(log n)的复杂度,因为可能需要调整的层数等于堆的高度。
1 | class MinHeap { |
字典序Trie树
点击展开
What(什么):字典序,也称为词典序或者字母序,是一种排序方法,它按照字母或者数字的顺序进行排序,就像在字典中查找单词一样。
Who(谁):程序员和数据科学家经常需要使用字典序,例如在处理字符串或者文本数据时,可能会用到字典序。在数据库查询中,也常常需要按照字典序进行排序。
When(何时):当需要对字符串或者文本数据进行排序,或者需要在数据库中进行查询时,可能会用到字典序。
Where(何地):字典序可以在任何需要排序或者查询的地方使用,例如在编程语言中处理字符串,或者在数据库中进行查询。
Why(为什么):字典序可以帮助我们按照一定的顺序组织和查找数据,使得数据更容易被理解和处理。
How(如何):在大多数编程语言中,都有内置的字符串比较函数,可以直接用来实现字典序。如果需要自定义字典序,可以使用数据结构(例如Trie)或者算法(例如字典序的下一个排列算法)来实现。
实现方式:用前缀树实现字典序
1 | class TrieNode { |
上面这个Trie实现支持插入、查找和前缀查找操作。每个TrieNode包含一个指向26个子节点的指针数组(对应26个英文字母)和一个标记该节点是否为一个单词的结束的布尔值。插入操作是将一个单词的每个字符按顺序插入到Trie中,查找操作是检查一个单词是否存在于Trie中,前缀查找操作是检查一个前缀是否存在于Trie中。
位运算拾疑
点击展开
程序中的所有数在计算机内存中都是以二进制的形式储存的。位运算说到底,就是直接对整数在内存中的二进制位进行操作。使用位运算,主要目的是节约内存,使你的程序速度更快,还有就是对内存要求苛刻的地方使用。
位运算在面试中的“初衷”是考察面试者的基本功,但不幸的是,位运算所考察的知识点,大部分属于知道就知道, 不知道不知道的类型。所以有必要先知道一下。
-
按位与(&):将两个数的对应位进行与操作,如果两个数的对应位都为1,则结果为1,否则为0。常用于清零特定位、判断某个位是否为1等操作。 -
按位或(|):将两个数的对应位进行或操作,如果两个数的对应位中有一个为1,则结果为1,否则为0。常用于将特定位设置为1。 -
按位异或(^):将两个数的对应位进行异或操作,如果两个数的对应位不同,则结果为1,否则为0。常用于交换两个数的值、清除特定位等操作。 -
按位取反(~):将一个数的所有位取反,即将0变为1,将1变为0。常用于对数的位进行取反操作。 -
左移(<<):将一个数的所有位向左移动指定的位数,高位丢弃,低位补0。常用于实现乘以2的n次方。 -
右移(>>):将一个数的所有位向右移动指定的位数,低位丢弃,高位根据情况补0或者补符号位。常用于实现除以2的n次方。
奇技淫巧和常见用途:
- 交换两个数的值:使用按位异或(^)运算,即a ^= b; b ^= a; a ^= b;。
- 判断奇偶性:使用按位与(&)运算,奇数的最后一位为1,偶数的最后一位为0。
- 清零特定位:使用按位与(&)运算,将指定位设置为0。
- 设置特定位:使用按位或(|)运算,将指定位设置为1。
- 快速计算2的幂:使用左移(<<)运算,将1左移n位得到2的n次方。
- 判断一个数是否是2的幂:使用按位与(&)运算,2的幂的二进制表示中只有一位为1,其余为0,所以 n & (n - 1) == 0 表示 n 是2的幂。
1 |
|
拓展阅读:
业务技能
Protobuf和Json有什么区别,车内通信应用领域有何不同?
点击展开
Protocol Buffers
(protobuf) 和 JSON 是两种常用的数据序列化格式,它们都可以用于数据存储和通信。然而,它们在设计理念、性能和使用场景上有一些重要的区别:
-
数据大小和速度:Protobuf 通常比 JSON 更小,更快。Protobuf 是二进制格式,比 JSON 的文本格式更紧凑,因此在网络传输和数据存储上更有效率。同时,Protobuf 的解析和序列化速度也通常比 JSON 更快。
-
类型安全:Protobuf 是静态类型的,需要预先定义数据结构(在 .proto 文件中)。这意味着你可以在编译时获取类型安全性,并且可以利用 Protobuf 编译器生成的代码来读写数据。而 JSON 是动态类型的,数据结构可以在运行时改变,这在某些情况下可能更灵活,但也可能导致更多的运行时错误。
-
可读性和互操作性:JSON 是人类可读的,可以直接在文本编辑器中查看和编辑,而且被广泛支持在几乎所有的编程语言中。而 Protobuf 是二进制格式,不易于直接阅读和编辑,但它提供了工具可以将数据转换为可读的文本格式。Protobuf 的支持也比较广泛,但可能不如 JSON 那么普遍。
-
版本兼容性:Protobuf 设计了一套规则来处理数据结构的变化,使得新旧版本的数据结构可以相互兼容。而在 JSON 中,如果数据结构发生变化,可能需要更多的手动处理来保证兼容性。
总的来说,Protobuf 和 JSON 各有优势,适用于不同的场景。在需要可读性和广泛的语言互操作性的 Web 开发中,JSON 是一个很好的选择,因为
HTTP 请求和响应通常需要在多种不同的平台和语言之间进行交互。
在需要高效性能和强类型的车载网络通信中,Protobuf 是更好的选择,因为因为车载系统通常有严格的性能和资源限制,在车载网络中,带宽和资源通常是有限的,因此需要使用更高效的数据格式。Protobuf 的二进制格式比 JSON 的文本格式更紧凑,因此可以更有效地利用网络带宽。
拓展阅读:
介绍下DoIP报文的格式。
点击展开
DoIP(Diagnostic over Internet Protocol)是一种在以太网上进行车辆诊断的协议。它是基于TCP/IP和UDP/IP的,允许在车辆网络中进行高速、高效的数据传输。
DoIP报文的基本格式如下:
协议版本:这是一个8位的字段,表示DoIP协议的版本。当前的版本是0x02。
载荷类型:这是一个16位的字段,表示载荷的类型。例如,诊断消息、车辆识别请求等。
载荷长度:这是一个32位的字段,表示载荷的长度(以字节为单位)。
载荷:这是一个可变长度的字段,包含载荷的实际数据。其内容和长度取决于载荷类型。
源地址:这是一个16位的字段,表示发送节点的地址。
目标地址:这是一个16位的字段,表示接收节点的地址。
在实际使用中,DoIP报文通常会被封装在TCP或UDP报文中,然后通过以太网进行传输。具体的传输协议(TCP或UDP)取决于载荷类型和特定的应用需求。
拓展阅读:
介绍下CAN报文的格式以及在工作中是如何分析CAN报文的。
点击展开
CAN(Controller Area Network)报文主要有两种格式:标准格式(CAN 2.0A)和扩展格式(CAN 2.0B)。其基本格式包括:起始位、仲裁域(包括标识符和远程传输请求位)、控制域(包括数据长度代码)、数据域、CRC域、确认域和结束位。上述两种格式的主要区别在于标识符的长度,标准格式的标识符是11位,而扩展格式的标识符是29位。
以下是CAN报文的基本结构:
-
起始位(Start of frame):这是一个固定为0的位,表示报文的开始。
-
仲裁域(Arbitration field):这个域包括标识符和远程传输请求位(RTR)。标识符用于标识报文的类型或目的。RTR位用于区分数据帧(RTR=0)和远程帧(RTR=1)。
-
控制域(Control field):这个域包括数据长度代码(DLC),表示数据域中的字节数(0到8字节)。
-
数据域(Data field):这个域包含报文的数据,长度由DLC指定。
-
CRC域(CRC field):这个域包含一个15位的循环冗余校验序列和一个固定为1的分隔位。
-
确认域(ACK field):这个域包括一个确认位和一个固定为1的分隔位。发送节点将确认位设置为0,接收节点在成功接收报文后将其设置为1。
-
结束位(End of frame):这是一个固定为1的位,表示报文的结束。
在CAN网络中,所有节点都会监听网络上的所有报文,并根据报文的标识符决定是否处理报文。当多个节点同时发送报文时,标识符较小的报文(即优先级较高的报文)会被优先发送。这是通过CAN协议的仲裁机制实现的。
有一些工具可以帮助在工作中分析CAN报文,例如Wireshark、Vector CANoe等。这些工具可以自动解析CAN报文,并提供一些高级的功能,如报文过滤、触发条件等。
简单介绍下MQTT的消息格式、消息类型、服务质量和连接保活特征。
点击展开
MQTT(Message Queuing Telemetyr Transport 消息队列遥测传输协议):基于发布/订阅模式的轻量级通讯协议,该协议构建于TCP/IP协议之上。MQTT运行于TCP之上,属于应用层协议。
-
消息格式:每条MQTT命令消息的消息头都包含一个固定的报头,有些消息会携带一个可变报文头和一个负荷。消息格式如下:
`固定报文头` | `可变报文头` | `负荷`
-
固定报头:最少有两个字节,第一个字节包含消息的类型(Message Type)和QoS级别等标志位。第二个字节开始是剩余长度字节,该长度是后面的可变报文头加消息负载的总长度,该字段最多允许四个字节。剩余长度字段单个字节的最大值为0x7F. 也就是127个字节。MQTT协议规定,单个字节的最高位如果是1,表示后续还有字节存在,第八位起延续位的作用。由于MQTT协议最多使用四个字节表示剩余长度,并且最后一个字节的最大值只能是0x7F,而不是0xFF。所以能发送的最大消息长度是256MB,而不是512MB。
-
可变报头:主要包含协议名,协议版本,连接标志,心跳间隔时间,连接返回码,主题名等。
-
负荷:实际上可以理解为消息的主体。当MQTT发送的消息类型是CONNECT(连接)、PUBLISH(发布)、SUBSCRIBE(订阅)、SUBACK(订阅确认)、UBSUNSCRIBE(取消订阅)时会带有负荷。
- 消息类型:固定报文头中的第一个字节包含连接标志,连接标志用来区分MQTT的消息类型。MQTT协议拥有14中不同的消息类型。如下表,可简单分为连接及终止、发布和订阅、Qos2消息的机制以及各种确认ACK。
| 类型名称 | 类型值 | 报文说明 | 流动方向 |
|---|---|---|---|
| CONNECT | 1 | 客户端请求连接到服务器 | 客户端到服务器 |
| CONNACK | 2 | 连接确认 | 服务器到客户端 |
| PUBLISH | 3 | 发布消息 | 客户端到服务器,服务器到客户端 |
| PUBACK | 4 | 发布确认,针对QoS 1消息 | 客户端到服务器,服务器到客户端 |
| PUBREC | 5 | 发布收到(保证交付第一步),针对QoS 2消息 | 客户端到服务器,服务器到客户端 |
| PUBREL | 6 | 发布释放(保证交付第二步),针对QoS 2消息 | 客户端到服务器,服务器到客户端 |
| PUBCOMP | 7 | 发布完成(保证交付第三步),针对QoS 2消息 | 客户端到服务器,服务器到客户端 |
| SUBSCRIBE | 8 | 客户端订阅请求 | 客户端到服务器 |
| SUBACK | 9 | 订阅确认 | 服务器到客户端 |
| UNSUBSCRIBE | 10 | 取消订阅请求 | 客户端到服务器 |
| UNSUBACK | 11 | 取消订阅确认 | 服务器到客户端 |
| PINGREQ | 12 | PING请求 | 客户端到服务器 |
| PINGRESP | 13 | PING响应 | 服务器到客户端 |
| DISCONNECT | 14 | 客户端断开连接 | 客户端到服务器 |
- 服务质量:MQTT消息质量有三个等级,QoS 0、Qos 1、Qos 2。
-
Qos 0:最多分发一次,消息的传递完全依赖底层的TCP/IP网络,协议里没有定义应答和重试。消息只会到达服务端一次,要么就没到达。
-
Qos 1:至少分发一次、服务器的消息接收由PUBACK消息进行确认,如果通信链路或设备异常,或指定时间内没有收到确认消息,发送端会重发这条在消息头中设置了Dup位的消息。
-
Qos 2:只分发一次。最高级别的消息传递,消息丢失和重复都是不可接受的,使用这个服务质量等级会有额外的开销。
- 连接保活机制:MQTT客户端可以设置一个心跳间隔时间(keep Alive Timer),表示在每个心跳检测时间内发送一条消息。如果在这个时间周期内,没有业务数据相关的消息,客户端会发送一个PINGREQ消息,相应的,服务器会返回一个PINGRESP消息进行确认。
如果服务器在一个半(1.5)个心跳间隔时间周期内没有收到来自客户端的消息,就会断开与客户端的连接。心跳间隔时间最大值可以设置为18个小时,8表示客户端不会断开。
AUTOSAR 是做AP还是CP,两者有什么区别,简要介绍下?
点击展开
• 汽车领域的一套标准软件架构
• AUTOSAR的主要内容:
    ○ 完整的基础软件架构:框架,系统有哪些模块,模块间的交互
    ○ 汽车应用接口规范
    ○ 验收测试规范
    ○ 方法论
• CP:基于传统ECU的嵌入式软件平台
• AP:基于高性能智能ECU的软件中间件 [C++11、SOA、Security]
• 功能模块介绍—AP:
    ○ 通信模块(ara::com):模块和外界交互,SOME/IP、DDS、Signal PDU、IPC
    ○ 执行模块(ara::exec):模块在系统中如何跑起来,由一个可执行程序变成进程,管理其启动时和运行时的一些进程的行为。
    ○ 持久化模块(ara::per):进程记录一些数据,读写一些信息,和外界配置信息交互
    ○ 时间同步(ara::tsync):高精度时间保证。
    ○ 日志追踪(ara::log):模块运行的记录日志。
    ○ 状态管理(ara::sm):模块的状态转换。
    ○ 升级管理(ara::ucm):软件升级
    ○ 诊断管理(ara::diag)
TC397
点击展开
国内L2+大多数方案 MCU:TC397 SoC:TDA4VM
CP AUTOSAR一般运行在8bit、16bit、32bit的微控制器(MCU)中,如英飞凌的TC3xx,瑞萨的RH850等。AP AUTOSAR可以运行在64bit的高性能处理器(MPU)、CPU等中,如瑞萨的H3,英伟达的Xavier等。除此之外,AP AUTOSAR也可以运行在虚拟硬件上。CP AUTOSAR OS是基于OSEK标准的。 AP AUTOSAR OS是POSIX OS,且至少应包含PSE51子集。
注:OSEK/VDX、POSIX和PSE51都是操作系统标准,主要用于嵌入式系统和实时系统。
OSEK/VDX:这是一个为汽车电子控制单元(ECU)开发的开放式标准。它定义了一个实时操作系统(RTOS)的接口,以及一些相关的服务,如网络通信和诊断。OSEK/VDX标准旨在提供一个跨多个硬件平台的统一的软件架构,以简化汽车电子系统的开发和维护。
POSIX:这是一组由IEEE定义的操作系统接口标准,旨在提高软件的可移植性。POSIX标准定义了一组核心的API和服务,包括文件系统操作、进程管理、线程管理、和信号处理等。许多操作系统,包括大多数Unix和Linux变种,以及一些嵌入式操作系统,都提供了对POSIX标准的支持。
PSE51:这是POSIX标准的一个子集,专门为小型嵌入式实时系统设计。PSE51标准定义了一组最小的、对实时系统有用的API和服务,包括线程管理、时间管理、和信号量等。PSE51标准旨在提供一个适合资源受限环境的、可移植的操作系统接口。
FOTA和TBOX的通信怎么做
点击展开
云端和TBOX的通信,一边是上行和下行的通信,下行一般采用MQTT协议,将云端的信息通知给TBOX,上行信息一般较多,如版本信息、安装进度、安装状态等,一般采用HTTPS的POST、GET请求和云端交互,设计到指定的一系列车云REST接口。
MQTT:MQTT 是一种基于发布/订阅模式的轻量级消息协议,特别适合在网络带宽较小、不稳定或高延迟的环境中使用。在车云通信的下行通信中,云端需要将信息(如 FOTA 更新)推送给 TBOX,这种一对多的通信模式非常适合 MQTT。此外,MQTT 还支持持久会话和消息存储,可以确保重要的信息不会丢失。
HTTPS:HTTPS 是 HTTP 的安全版本,它在 HTTP 上添加了 SSL/TLS 协议,可以提供数据的加密传输、身份验证和消息完整性检查。在车云通信的上行通信中,TBOX 需要将信息(如版本信息、安装进度、安装状态等)发送给云端,这种一对一的通信模式非常适合 HTTPS。此外,HTTPS 的 POST 和 GET 请求可以方便地与云端的 REST 接口进行交互。
诊断仪的代码移植
点击展开
-
理解源代码:首先,需要理解源代码的功能和结构,包括各个模块的作用,以及它们之间的交互方式。
-
选择目标平台:然后,需要选择一个目标平台,这可能是一个不同的操作系统,或者一个不同的硬件架构。
-
设置开发环境:根据目标平台,设置相应的开发环境,包括编译器、调试器等工具。
-
修改代码:根据目标平台的特性,修改源代码。这可能包括修改硬件抽象层(HAL),修改操作系统相关的代码,以及修改编译器特定的代码等。
-
编译和测试:编译修改后的代码,并在目标平台上进行测试。测试应该包括功能测试,性能测试,以及稳定性测试等。
-
优化和调试:根据测试结果,进行必要的优化和调试。
代码移植之后怎么做验证
点击展开
-
单元测试:对每个函数或模块进行独立的测试,使用
EXPECT_EQ宏来检查响应是否等于预期的响应,以确保它们在新环境中的功能正确。(1.车云接口 2.整车版本 3.网络丢包) -
集成测试:在所有模块组合在一起后进行测试,以确保它们能够正确地协同工作。(编译通过)
-
系统测试:在整个系统级别进行测试,以确保所有组件和服务在一起工作时的行为符合预期。(放到板子上跑)
-
性能测试:测试系统在高负载或大数据量下的性能和稳定性。(压测)
-
回归测试:在每次修改代码后,重新运行所有的测试,以确保修改没有引入新的错误。(查缺补漏)
-
验收测试:最后,进行验收测试,以确保系统满足所有的业务需求和用户需求。(质量部门)
CMake的基础用法
点击展开
https://zhuanlan.zhihu.com/p/662623216
CMake是一个跨平台的自动化构建系统,主要用来管理软件构建的过程,它使用一个名为CMakeLists.txt的配置文件来指导编译和链接的过程。
make_minimum_required(VERSION x.x): 指定项目需要的最低CMake版本。
project(ProjectName): 定义项目的名称和使用的语言。
add_executable(TargetName source1 source2 ...): 添加一个可执行目标,并指定其源文件。
add_library(TargetName type source1 source2 ...): 添加一个库目标,并指定其类型(静态或动态)和源文件。
find_package(PackageName): 查找并加载外部依赖包。
target_link_libraries(TargetName library1 library2 ...): 指定目标链接的库。
MCU 和 SoC 两套升级范式说明
点击展开
MCU 世界观(地址+字节+UDS 刷写)和 SoC 世界观(分区+文件+镜像切换)是完全两套升级范式:
-
UDS 34/36/37 刷写"的典型对象是 MCU 型 ECU:车身/底盘或嵌入式控制器,以及域控内部的安全岛 MCU。执行者是 ECU 里常驻的 bootloader,本质是"通过诊断通道把字节流写进它的内部 flash 地址"。
-
高通、联发科、英伟达、地平线这类智能域控,OTA 不走 34/36/37 逐块塞 flash 的范式,它们是大 SoC + eMMC/UFS + 完整 OS + 文件系统,走的是文件/镜像级分区升级,具体而言是:域控制器的存储上有两组分区槽位(slot A / slot B),每组包含 boot、system、vendor、vbmeta 等多个分区,升级时跑在域控 SoC 里的安装守护进程负责写升级意图、bootloader 启动时执行槽位切换动作,二者的通信的介质就是 BCB/misc 或 U-Boot env 这类参数区。UDS 只在"产线首刷、售后恢复、中央网关代刷"场景里当传输通道用。
-
Bootloader = 上电后最先跑的程序,四大职责:
- 加载启动 OS/App;
- MCU 刷写的宿主,接收 UDS 服务写 flash;
- 读启动参数区决定启动哪个 slot、数失败次数、自动回滚;
- 逐级验签形成安全启动信任链。
-
update_engine/update_agent/RAUC = 跑在 SoC 里的服务,作用:
- 把镜像落进非激活分区;
- 调 bootctl/写 U-Boot env/写 BCB,完成"激活 inactive slot";
- 把要激活分区标记为"可启动/新版本/attempt=1"
- 重启后,bootloader 读安装器写入的元数据,验签 B 的镜像,决定引导 B,同时记启动次数或者回滚到 A。
诊断刷写的流程
点击展开
诊断刷写通常是指在汽车诊断过程中,通过诊断工具将新的固件刷写到汽车的电子控制单元(ECU)中。以下是一个基本的诊断刷写流程:
软件刷写总体上分为三个步骤:
- pre-programming
- programming
- post-programming
刷写前:
Step 1:切换到拓展模式(10:会话控制 03:拓展会话)
Step 2:检查刷写前提条件,如条件不满足,则退出刷写。(31:例程控制 01:启动例程 XXX:例程ID,如车速、电源等)
Step 3:停用故障码存储功能,屏蔽故障(85:故障码控制设置 02:停止故障码存储)
Step 4:停止发送一切通讯报文,关闭与诊断无关的报文,将节约出来的通信资源用于刷写软件,提升刷写速度。(28:通信控制 01:停止发送报文和接收报文 01:一般通信报文 XXX结点识别号)
Step 1:进入编程模式(10:会话控制 02:编程会话)
Step 2:使用27服务进行安全访问(27:安全访问 01:请求种子 02:发送与验证Key)
Step 3:写入指纹信息,即标记写软件人的身份(2E:DID写入)
Step 4:擦除内存(31:例程控制 01:启动例程 FF 00:例程ID,擦除存储数据)
Step 5:调用34,36,37服务完成数据的写入。(34:请求下载 36:传输数据 37:请求传输退出)
Step 6:执行31服务,检查刚刚写入的数据块是否正确,典型的就是执行checksum验证。如果还有数据块要写,则再跳回Step 5,如果没有,则进入Step 7。(31:例程控制 01:启动例程 02 02:例程ID,检查内存 FF 01: 检查编程依赖)
Step 7:写入所有数据块之后,一个完整的软件也就写好了,此时需要ECU检查一下这个软件是否可用,比如软硬件兼容问题。(11:ECU复位 01:硬件复位)
Step 1:切换到拓展模式(10:会话控制 03:拓展会话)
Step 2:启用发送一般性通讯报文(28:通信控制 00:启用发送报文和接收报文 01:一般通信报文 XXX结点识别号)
Step 3:各个ECU回复故障码的检测(85:故障码控制设置 01:启动故障码存储)
Step 4:ECU回到默认模式(10:会话模式 01:默认会话)
A/B分区
点击展开
- 什么是A/B分区系统呢?
答:A分区或者B分区系统独立,两者之间可以相互切换的系统。
- 为什么需要这样的系统呢?
答:在没有A/B功能之前,车辆控制器的刷写需要车辆停车,满足一定的安全刷写条件后,使用诊断仪或者其他上位机刷写。这一系列的操作,费时费力。为了最大程度的节省刷写时间,给用户更好的升级体验,静默刷写来了。而静默刷写建立的基础就是A/B功能,即:激活的分区,可以在车辆运行的过程中更新非激活分区。
- 非激活分区完成更新以后,何时切换分区?
非激活分区(A分区或者B分区)完成软件更新以后,需要在下次系统启动(一般需要MCU进行系统级复位)时,进行分区切换。
- A/B分区均启动失败以后,应该如何处理?
如果A/B分区均启动失败,程序应该进入诊断的编程会话(Programming Session),以便于程序可以被更新,避免控制器成为"板砖"。
为了Aspice做了那些工作
点击展开
ASPICE全称“AutomotiveSoftware ProcessImprovement and CapacityDetermination”,即汽车软件过程改进及能力评定。它是一个过程模型,由过程和能力度两个维度构成,用于评价汽车行业软件设计开发的能力水平。
ASPICE评估对象是项目,而不是产品或公司体系。ASPICE评估只能证明一个公司某个项目在某个时间段的过程能力情况。
1.编写和维护技术文档,包括系统软件技术规范(SSTS)、开发接口文档等,以确保所有的软件开发活动都有明确的指导和记录。
2.为下一个阶段的工作提供输入。例如,系统需求会为软件需求提供输入,这样可以让工作有章法可循。
3.使用Jira等缺陷跟踪管理系统,明确任务和缺陷。一级需求作为epic,二级需求作为story。在这个过程中,我会与产品经理反复沟通,明确我们的目标和预期结果。
4.进行定期的内部审计和评估,以确保我们的软件开发过程符合ASPICE的要求。
5.提供培训和指导,以确保团队成员理解和遵守ASPICE规范。
6.在软件开发过程中,我会确保所有的变更都经过严格的变更控制过程,包括变更请求的提交、评审、批准和实施。
最后,我会进行持续的过程改进,以提高我们的软件开发能力和成熟度。
进程crash之后的处理
点击展开
Native层Crash处理:
-
kernel捕捉到进程的异常信号(SIGABRT,SIGBUS,SIGFPE)时,调用信号处理函数;信号处理函数负责收集Crash进程的错误信息,并将错误信息通过socket发送给debugger守护进程;
-
debugger守护进程接收到crash信息后,一方面告知AMS有进程发生Crash,一方面通过tomestone保存完整的现场信息;
-
AMS收到Crash信息后,弹出对话框告知用户Crash信息,同时保存该crash进程的相关LOG;
-
出现 Crash 或 ANR,可以从以下几个方面处理:
可以先把墓碑文件导出来
然后再搜索其中的关键字,比如:exception、crash,看看是哪些方法或者异常导致了问题;
根据backtrace初步定位问题原因后,查找代码进行分析修复与验证。
1 | NullPointerException - 空指针引用异常 |
差分升级
点击展开
差分算法需要解决两个主要的问题:
- 如何高效的在old中寻找尽可能多的可用于构建new的数据流。
- 如何尽可能缩减描述old → new所需要的字节数。
新老版本切分成定长的数据库,计算各块的hash,通过比对hash来寻找新旧之间相同的数据块。
通过后缀排序算法预处理新旧文件,将预处理的结果以后缀数组和名次数组的形式存为字典目录,基于该字典目录能能够快速查找字典数据集和待编码数据集之间的相同数据段。
HdiffPatch 的差异性比较主要通过以下步骤实现:
-
使用
滑动窗口在旧文件中查找新文件中的数据块。这个过程使用了后缀数组和最长公共前缀数组来加速查找。 -
对于在旧文件中找到的数据块,生成一个指向旧文件中位置的
引用。 -
对于在旧文件中找不到的数据块,直接将这些数据包含在差分文件中。
-
将所有的引用和数据块按照在新文件中的顺序组合起来,生成差分文件。
在 HdiffPatch 的源代码中,以下是一些核心的函数和方法:
-
create_compressed_diff:这是创建差分文件的主要函数。它首先调用 search_cover 函数来查找在旧文件中的数据块,然后将找到的数据块和新文件中的其他数据一起压缩,生成差分文件。
-
search_cover:这个函数使用
滑动窗口和后缀数组来在旧文件中查找新文件中的数据块。 -
hdiff_private::getChecksum:这个函数用于计算数据块的校验和,用于快速比较数据块。
-
hdiff_private::save_compress:这个函数用于将数据块压缩并保存到差分文件中。
-
使用后缀数组和最长公共前缀数组加速查找:后缀数组是一个数据结构,它包含了一个字符串所有后缀的排序列表。最长公共前缀数组则存储了排序后的相邻后缀之间的最长公共前缀的长度。通过这两个数据结构,HdiffPatch 可以快速找到新文件中的数据块在旧文件中的位置。 -
使用滑动窗口查找数据块:为了减小差分文件的大小,HdiffPatch 使用一个滑动窗口在旧文件中查找数据块。这个窗口的大小是可配置的,通过调整窗口大小,可以在查找速度和差分文件大小之间找到一个平衡。 -
使用压缩算法减小差分文件的大小:HdiffPatch 支持多种压缩算法,包括 zlib,bzip2,lzma 等。通过压缩,可以进一步减小差分文件的大小。 -
使用校验和快速比较数据块:为了加速数据块的比较,HdiffPatch 使用校验和算法计算数据块的校验和。通过比较校验和,可以快速判断两个数据块是否相同。
BSDiff: APK差分升级
-
将旧文件二进制使用后缀排序或哈希算法形成一个字符串索引。
-
使用该字符串索引对比新文件,生成差异文件(difference file)和新增文件(extra file)。
-
将差异文件和新增文件及必要的索引控制信息压缩为差异更新包。
1)控制文件,包含需要添加和插入二进制段的指引信息(”添加指令”指定旧文件中的偏移量和长度,从旧文件读取适当的字节数,并将其添加到差异文件中的相同字节数;”插入指令”只是指定一个长度,指定的字节数是从额外的文件中读取的);
2)差异文件,包含近似匹配字段的字节差异;
3)新增文件,包含无法近似匹配的完全不同的字段。
这三个文件加一起会比新文件略大,但其中控制文件和差异文件是高度结构化的,意味着其均可被高效压缩,所以可以使用类似bzip2等压缩工具将更新包总文件进行非常有效的压缩。
Binder通讯原理解析
点击展开
- Binder 就是用来Client 端和 Server 端通信的。
- Binder借助了内存映射(mmap)的方法,在内核空间和接收方用户空间的数据缓存区之间做了一层内存映射。从发送方用户空间拷贝到内核空间缓存区的数据,就相当于直接拷贝到了接收方用户空间的数据缓存区,从而减少了一次数据拷贝。
- 内存映射能减少数据拷贝次数,实现用户空间和内核空间的高效互动。两个空间各自的修改能直接反映在映射的内存区域,从而被对方空间及时感知。也正因为如此,内存映射能够提供对进程间通信的支持。
- 一次完整的 Binder IPC 通信过程通常是这样:
- 1、首先 Binder 驱动在内核空间创建一个 数据接收缓存区 ;
- 2、接着在内核空间开辟一块内核缓存区,建立 内核缓存区 和 内核中数据接收缓存区 之间的映射关系,以及 内核中数据接收缓存区 和 接收进程用户空间地址 的映射关系;
- 3、发送方进程通过系统调用 copyfromuser() 将数据 copy 到内核中的内核缓存区,由于内核缓存区和接收进程的用户空间存在内存映射,因此也就相当于把数据发送到了接收进程的用户空间,这样便完成了一次进程间的通信。
Android 添加自定义 native 服务
点击展开
Native服务就是用C++写的系统服务,通过init进程启动,可以实现binder接口供client调用。
-
编写服务代码:首先,你需要用C++编写你的服务代码。这通常包括实现一个或多个Binder接口,这些接口将被其他进程(客户端)调用。
-
编写.rc文件:.rc文件是Android的init语言脚本,用于描述应该如何启动你的服务。你需要在这个文件中指定你的服务的名称、执行路径、所需的权限等信息。
-
编写Android.bp文件:Android.bp文件是Android构建系统的一部分,用于描述如何构建你的服务。你需要在这个文件中指定你的源代码文件、依赖库等信息。
-
编译和安装:使用Android构建系统(如mm或mmm命令)编译你的服务。编译成功后,.rc文件会被安装到/system/etc/init/目录下,你的服务的可执行文件会被安装到/system/bin/目录下(或其他你在.rc文件中指定的位置)。
-
配置SELinux策略:为了让你的服务在启动时能够获得必要的权限,你可能需要修改或添加SELinux策略。这通常涉及到编写.te文件和可能的.fc文件。
-
测试你的服务:重启你的设备,你的服务应该会在启动时自动运行。你可以使用ps命令检查你的服务是否正在运行,使用logcat命令查看你的服务的日志输出。